01
看见
从连续视觉流中找到结构
把视频当作事件沿时间展开,而非彼此孤立的帧。语义边界、事件锚点和长期记忆共同决定模型究竟看见了什么。
EFSWFS-SB
关于我
厦门大学 MAC 实验室人工智能方向博士生
我研究长时程视觉信息怎样进入多模态模型,也关心生成能否帮助模型理解世界。眼下的问题很具体。模型该怎样从连续视频中保留事件结构,怎样生成可检查的候选解释,又怎样回到原始证据里修正它们。
研究愿景
我希望构建能在现实时间尺度上持续看见、组织并理解多模态信息的系统。研究从长视频中的事件结构出发,进一步探究生成怎样提出可检验的假设,以及模型怎样在持续到来的视觉流中积累而不遗失证据。
现实中的视觉经验很少被整齐地切成一张张图片。一次实验、一段旅程或一场比赛会持续很久,真正影响判断的线索却只在少数时刻出现。模型需要知道哪里发生了变化,也要记得这些变化前后怎样相连。我的第一条研究线索由此展开。我尝试把视频里的语义边界、事件锚点和查询相关信息组织起来,让有限输入保留足够完整的故事。
生成给这条路线补上了另一种可能。模型可以先提出事件描述、缺失状态或未来走向,再回到观测中寻找支持与冲突。这样的生成结果只是一组候选,价值来自它让模糊的内部状态变得可以检查。一个候选若找不到时间位置、视觉实体或前后因果的支持,就应该被修改或舍弃。理解因此有了可操作的中间对象。
我最终想做的系统,应当能一边接收持续到来的视频,一边维护对事件的当前理解。它知道哪些内容已经确认,哪些仍是假设,旧证据在什么时候需要重新查看。模型给出的答案只是这一过程的一个出口。更重要的是,答案背后的事件表示能够随着新信息到来继续更新,并保留足够清楚的证据来路。
研究
从连续视频里的事件结构出发,让生成提出候选,再让证据完成核验。
从连续视觉流中找到结构
把视频当作事件沿时间展开,而非彼此孤立的帧。语义边界、事件锚点和长期记忆共同决定模型究竟看见了什么。
把模糊理解变成可检查的候选
让模型生成事件描述、缺失状态或可能的未来,把尚未成形的判断写成能够被定位、比较和否证的中间对象。
让理解随着证据继续更新
把候选重新放回时间线和原始视觉证据中检查。保留得到支持的部分,修正冲突之处,并在长时程场景里持续更新事件记忆。
Publications
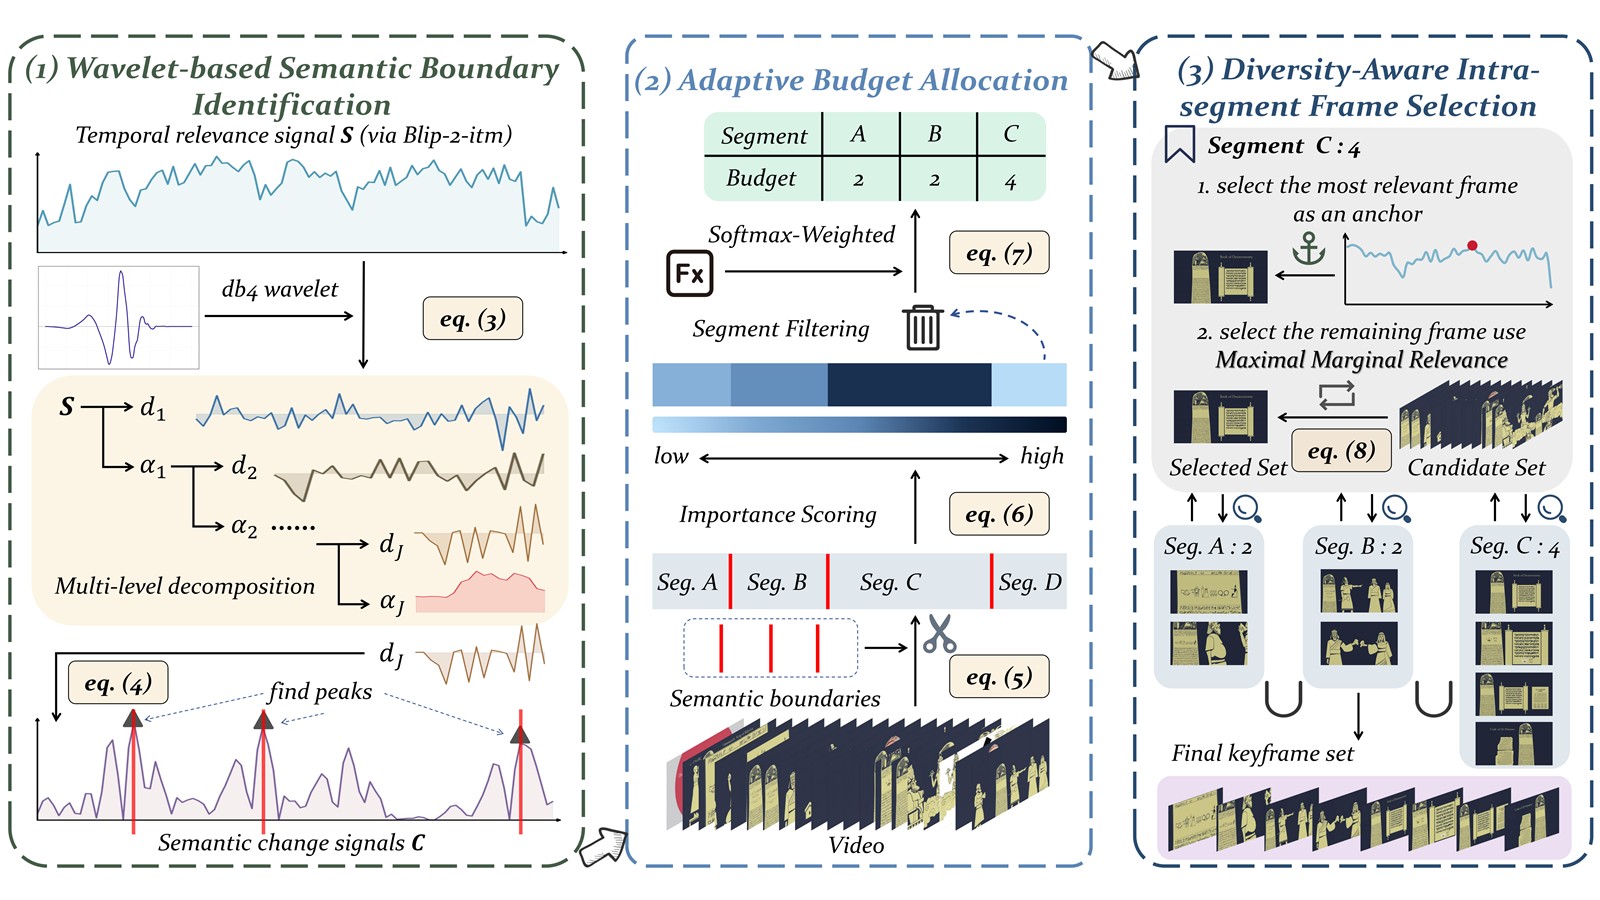
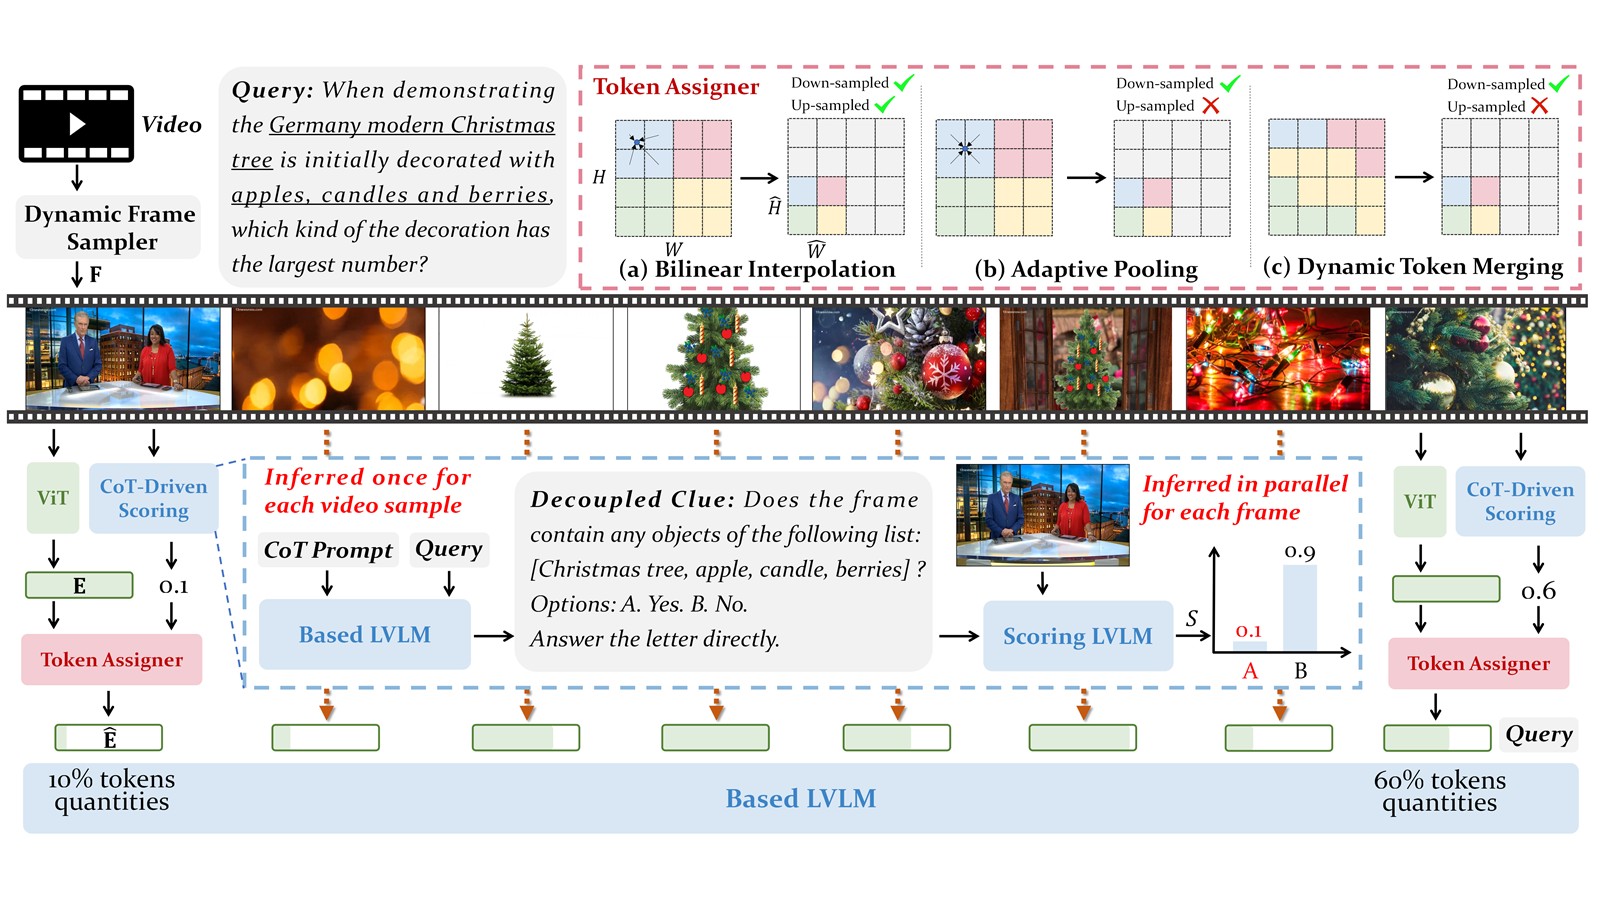
这些工作从不同尺度保留视频里的事件、边界与查询线索,也构成下一步研究的证据基础。
 2026
 2026
 2026
arXiv preprint · Equal contribution
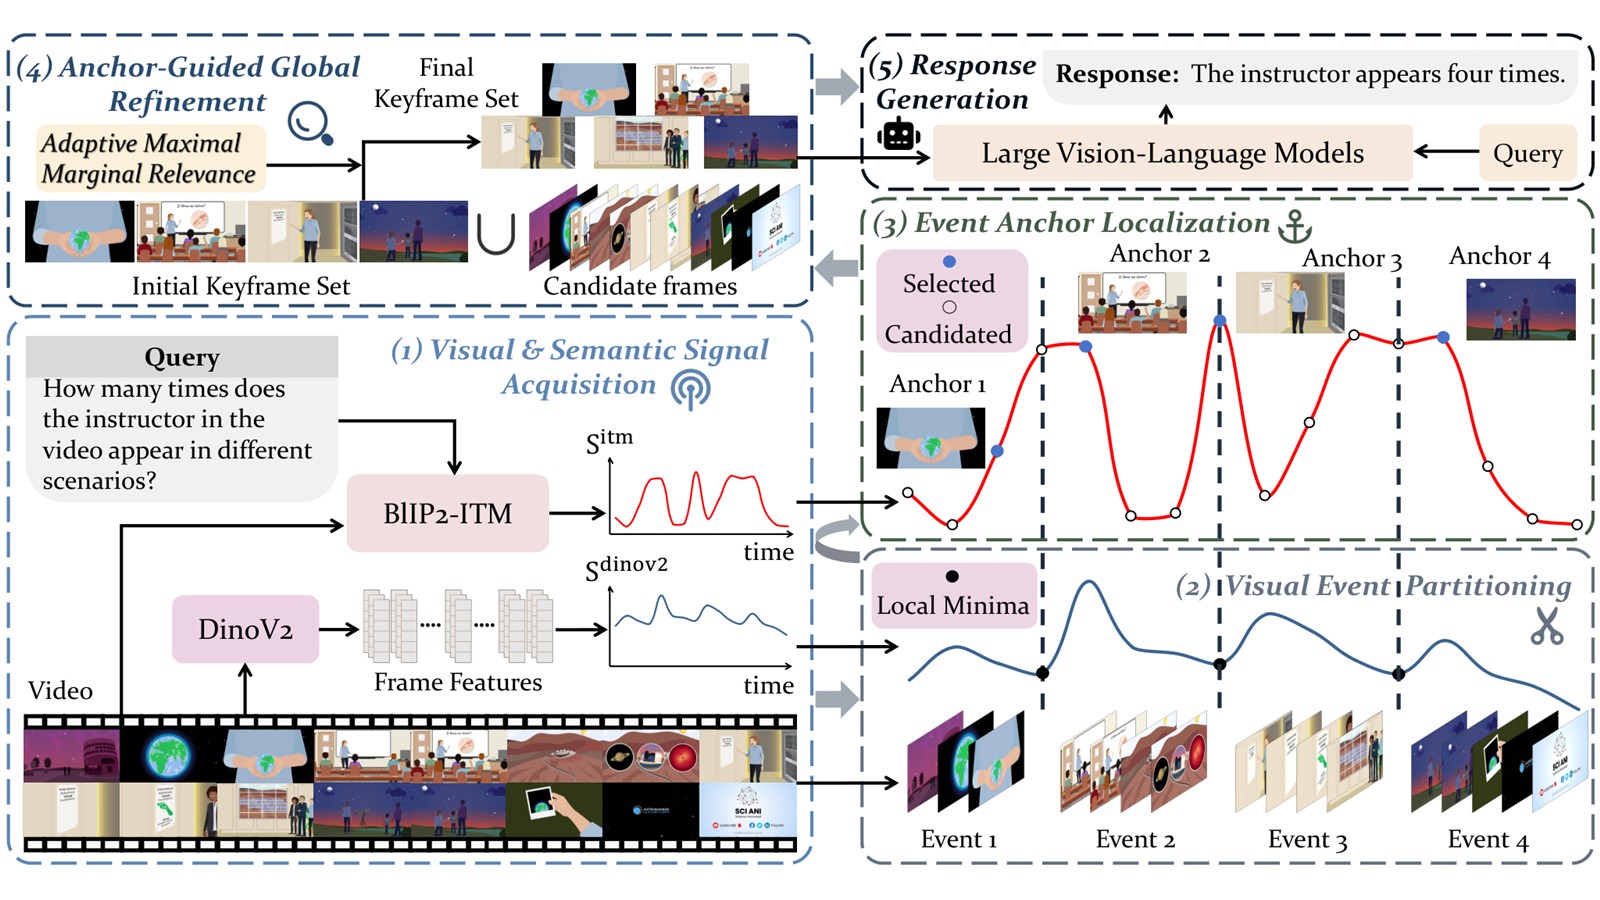
先把视频划成视觉一致的事件,再为每个事件定位查询相关锚点,最后用自适应 MMR 做全局补充,在覆盖、相关性和多样性之间取得平衡。
正在研究
下面是进行中的方向,只写问题和目标,结果留给实验。
研究生成目标、内部生成特征与候选假设怎样暴露模型尚未理解的部分,再用原始观测定位、核验和修正。
面向持续到来的视频,探索分层记忆、事件更新与证据回看,使模型在低延迟约束下保持长期理解。
News
进入厦门大学人工智能博士阶段,开始新的 PhD 生活。
加入高德地图(阿里巴巴集团)实习,关注多模态与视频理解。
WFS-SB 被 CVPR 2026 接收,代码已开源。
QuoTA 发表在 AAAI 2026。
Blog
从像素证据、可执行世界表示与溯因式发现循环出发,理解 Code-as-World 怎样把物理机制变成可运行、可检验、可修订的外显状态,以及这条路线离开放世界智能还有多远。
从流式视频评测、增量推理、长期状态、边看边想一路读到持续视觉智能。难点落在模型怎样随世界变化保存证据、安排计算,并为尚未出现的问题留下余地。
从视频编码基础一路读到 OneVision-Encoder、codec-video-prep、LLaVA-OneVision-2 与 Mage-VL 的论文设计、真实源码、复现差异和现有缺陷。
录取通知书其实已经拿到快一个月了。越是正式落下来,越觉得应该认真想一下,我为什么要读博。
Timeline
2026.09 起
MAC 实验室,导师曹刘娟教授、郑侠武副教授
2024.09 - 2026.08
在长视频理解与多模态推理方向开展研究
2026.05 至今
多模态与视频理解方向
2020.09 - 2024.06
本科阶段开始研究生成式视觉与人脸美学