Code-as-World 如何把世界写成一段可执行的假说
从像素证据、可执行世界表示与溯因式发现循环出发,理解 Code-as-World 怎样把物理机制变成可运行、可检验、可修订的外显状态,以及这条路线离开放世界智能还有多远。
项目页上有一个很直观的问题。蓝球沿斜坡滚下,它离开斜坡时速度是多少。人看见球在动,语言模型也能说出重力、加速和惯性。题目一旦要求米每秒,事情就变了。模型要知道画面里哪一个球是目标,斜坡多长,帧间隔是多少,透视怎样改变图像尺度,还要把这些测量放进同一套单位。
这类问题把视觉模型的一处短板照得很清楚。识别出一个物理事件,距离恢复这个事件背后的状态和机制还有很长一段路。视频告诉我们发生了什么,尺寸、质量、速度、接触关系与相机位置却没有直接写在像素里。模型可以生成一段很像真的未来视频,也可能一直没有决定画面变化究竟来自球的运动、相机的移动,还是一次暂时的遮挡。
我把 Code as Worlds 技术报告、MirroS 的两篇路线文章、项目页和当前公开仓库放在一起看,最值得细讲的正是它对这段距离的处理。Code-as-World 希望先从观测中提出一份显式世界假说,再让模拟器运行它,把运行结果投回可观察空间,随后根据差异修订假说。世界被写成 code,关键收益来自可执行和可检验。代码在这里承担的角色,比常见的结构化输出更重。
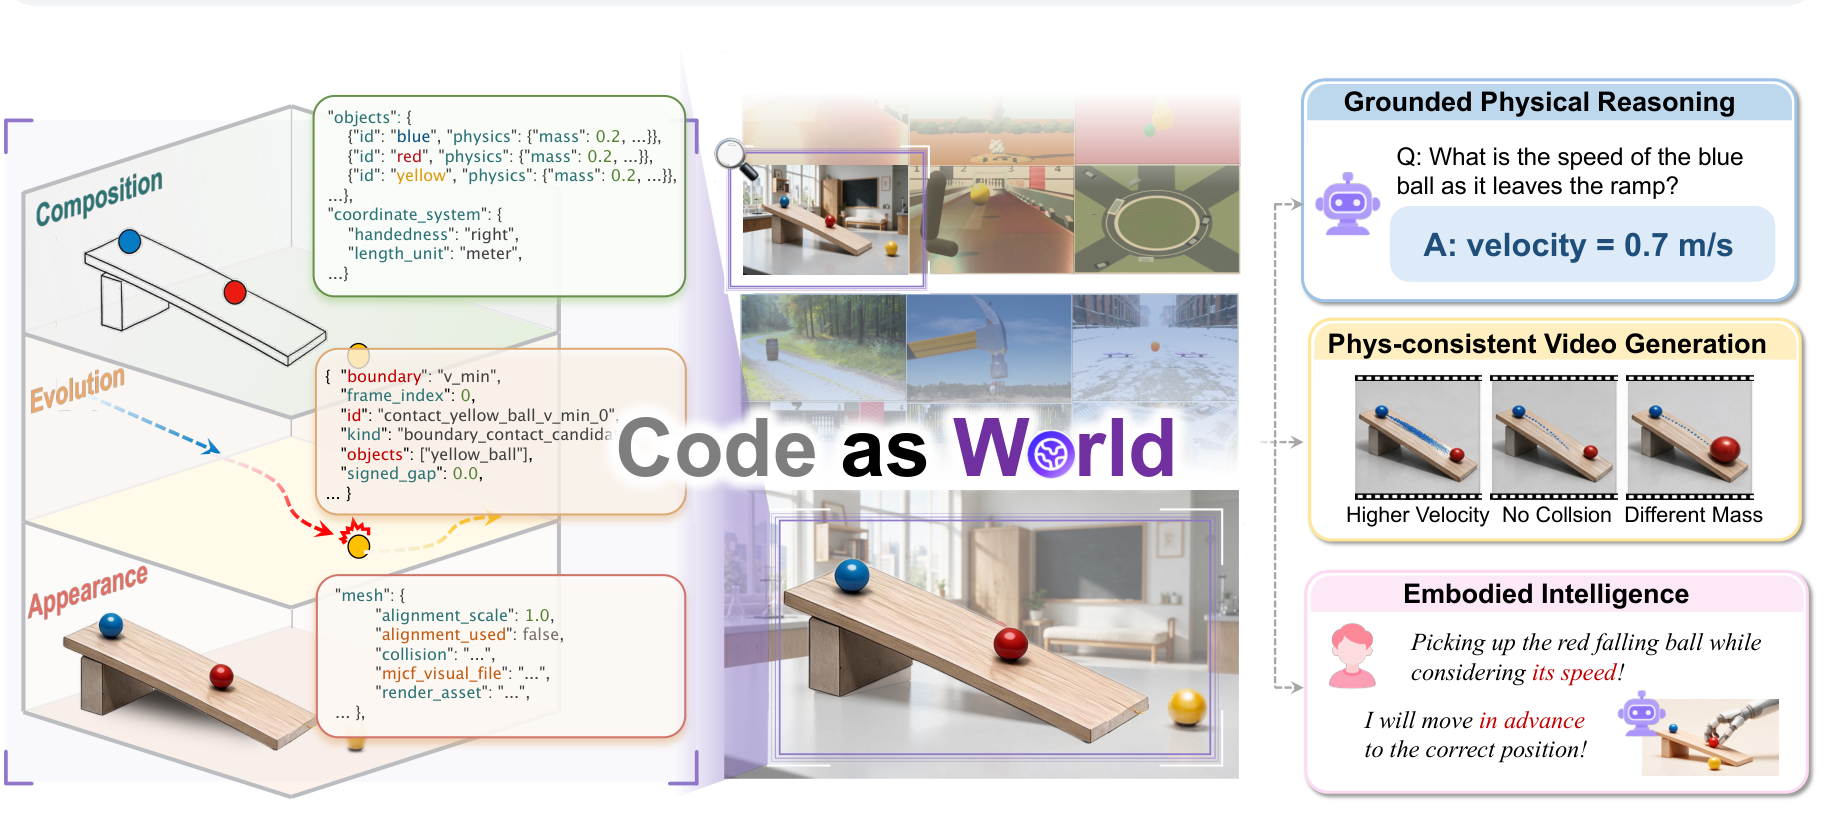
像素给出证据,理解需要恢复世界
MirroS 官方文章里有一句判断很准确,像素是物理世界的证据。它记录某个视角、某个时刻落在传感器上的结果。像素能保留丰富外观,也把形成这幅外观的因素叠在了一起。相机向左移和物体向右移可以产生近似的图像运动。两个质量不同的球,只要初始条件调得合适,也能在一小段视频里走出相近轨迹。
世界模型面对的是逆问题。给定观测 o[≤t],它要恢复一组潜在状态 s_t 和可能的演化规律,再预测动作 a_t 介入以后会发生什么。观测过程会丢信息,有限视频又只覆盖少量视角和时间。多套世界都可能解释同一段画面。
这件事决定了表示的意义。表示需要压缩观测,同时保留会改变未来的变量。先看这些变量有没有留下,再看纹理保存了多少。模型若分不清对象身份、支撑关系和接触事件,画面再清楚也很难回答反事实问题。把斜坡角度改小以后,球会在哪里落下。把杯子换成更重的金属杯,碰撞轨迹怎样变化。这样的提问要求模型维护一个可被干预的世界。
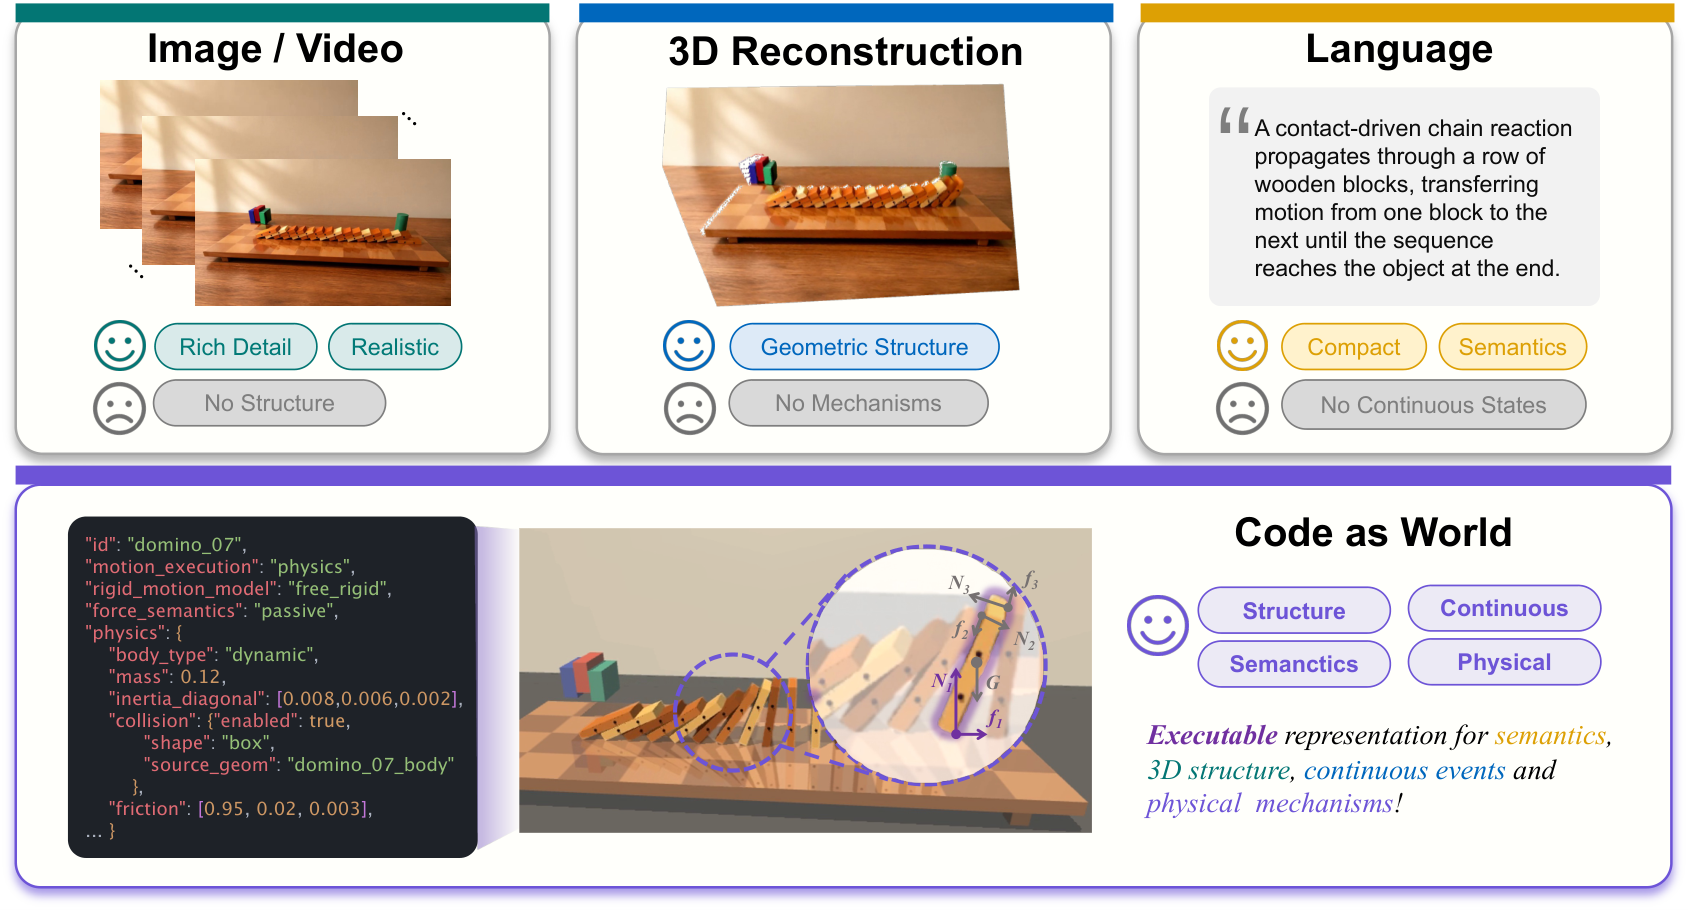
像素、三维、语言和 code 可以看成几种不同的信息取舍。
| 表示 | 擅长保存什么 | 容易缺少什么 |
|---|---|---|
| 图像与视频 | 外观、纹理和真实观测分布 | 对象身份、机制与视角因素常混在一起 |
| 三维重建 | 几何、相机和空间对应 | 质量、摩擦、受力与状态转移不会自动出现 |
| 自然语言 | 实体、事件、常识和高层因果 | 连续轨迹、精确接触和米制状态很难稳定表达 |
| 可执行 code | 显式变量、约束、单位和可干预规则 | 能表达什么受 schema 与模拟器范围限制 |
这张表不支持一种表示取代其余表示。Code-as-World 的实际系统仍然读取 RGB、深度、实例 mask、二维 track 和三维 mesh。LLM 提议世界假说时依赖自己的 latent 表征,视频生成器也要在高维 latent 中补充材质、光照和背景。code 负责固定对象身份、参数语义、单位和执行接口,让这些模块围绕同一份候选世界工作。
一份可执行世界里装着什么
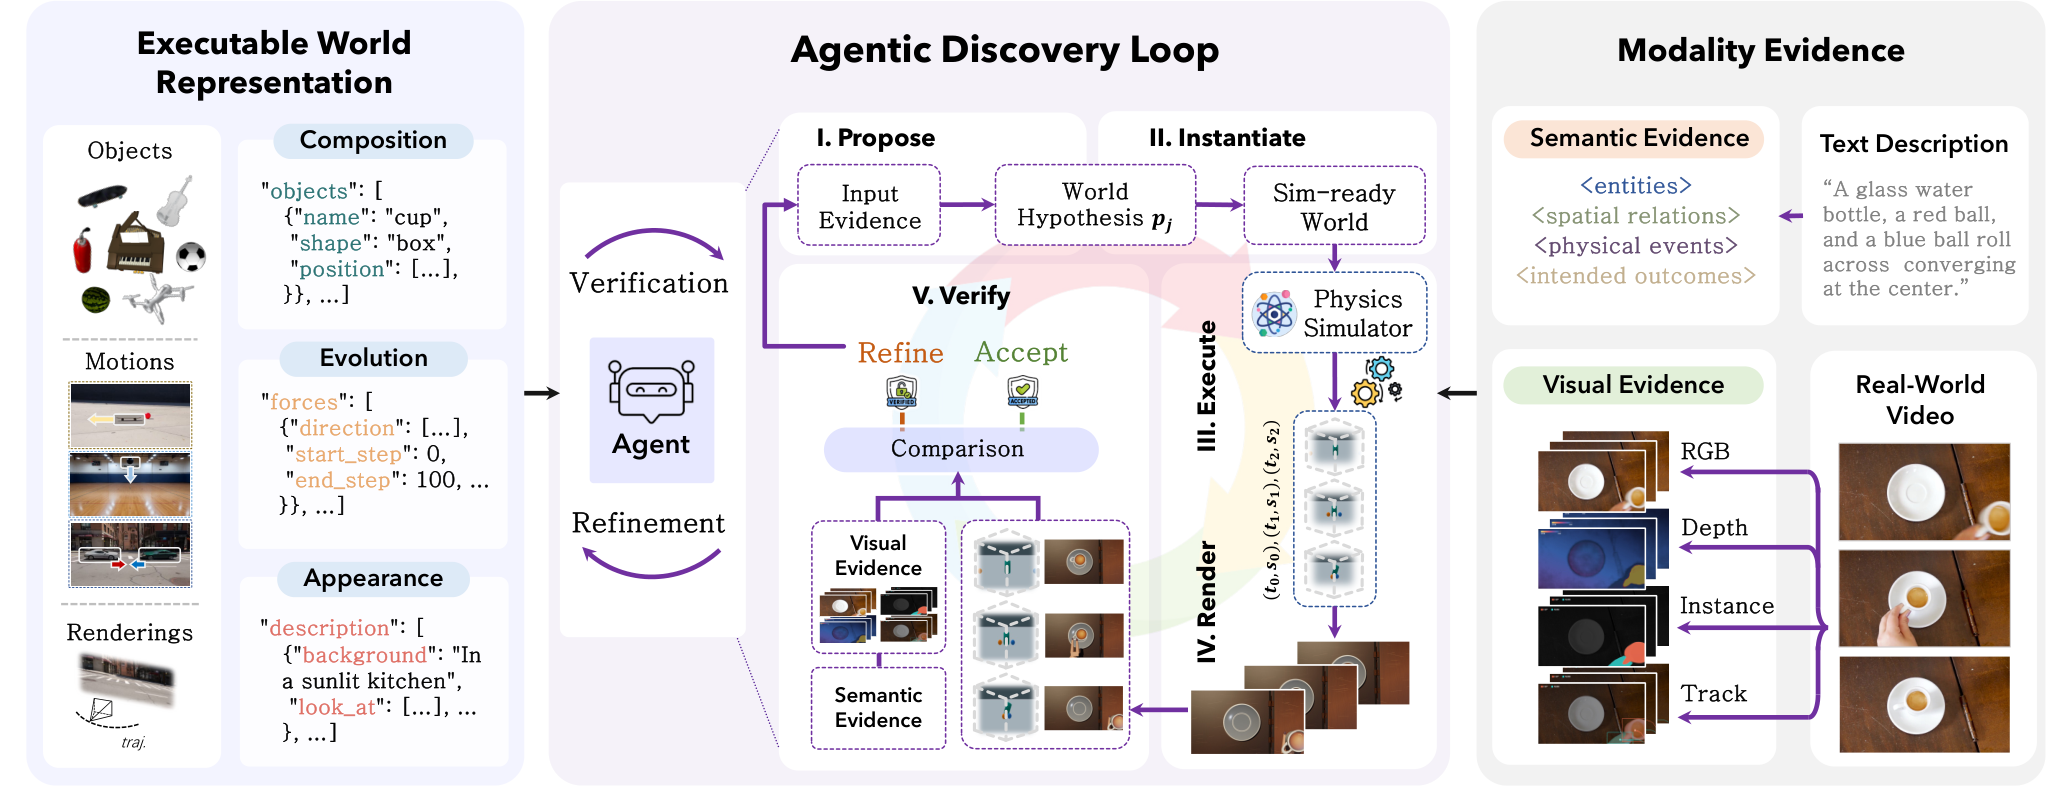
技术报告把 executable world representation 写成 p = (C, E, A)。三个部分分别回答世界里有什么、它怎样变化、这段变化怎样被观察。
| 组成 | 表示内容 | 典型变量 |
|---|---|---|
Composition C |
持久对象、环境结构与相对稳定的物理属性 | 几何、尺度、质量、摩擦、重力、地面和墙 |
Evolution E |
初始状态与随时间展开的动力学过程 | 位置、速度、力、接触、碰撞、轨迹和终止条件 |
Appearance A |
物理过程被观察和呈现的方式 | 相机、材质、背景、光照、帧率和生成条件 |
这个划分看着朴素,里面有一个很有用的约束。参与支撑与碰撞的地面属于 Composition,只提供画面气氛的背景属于 Appearance。改变墙面的纹理,不该改变球的反弹轨迹。改变恢复系数,则应该改变 Evolution。系统由此能够区分物理等价和逐像素复刻。
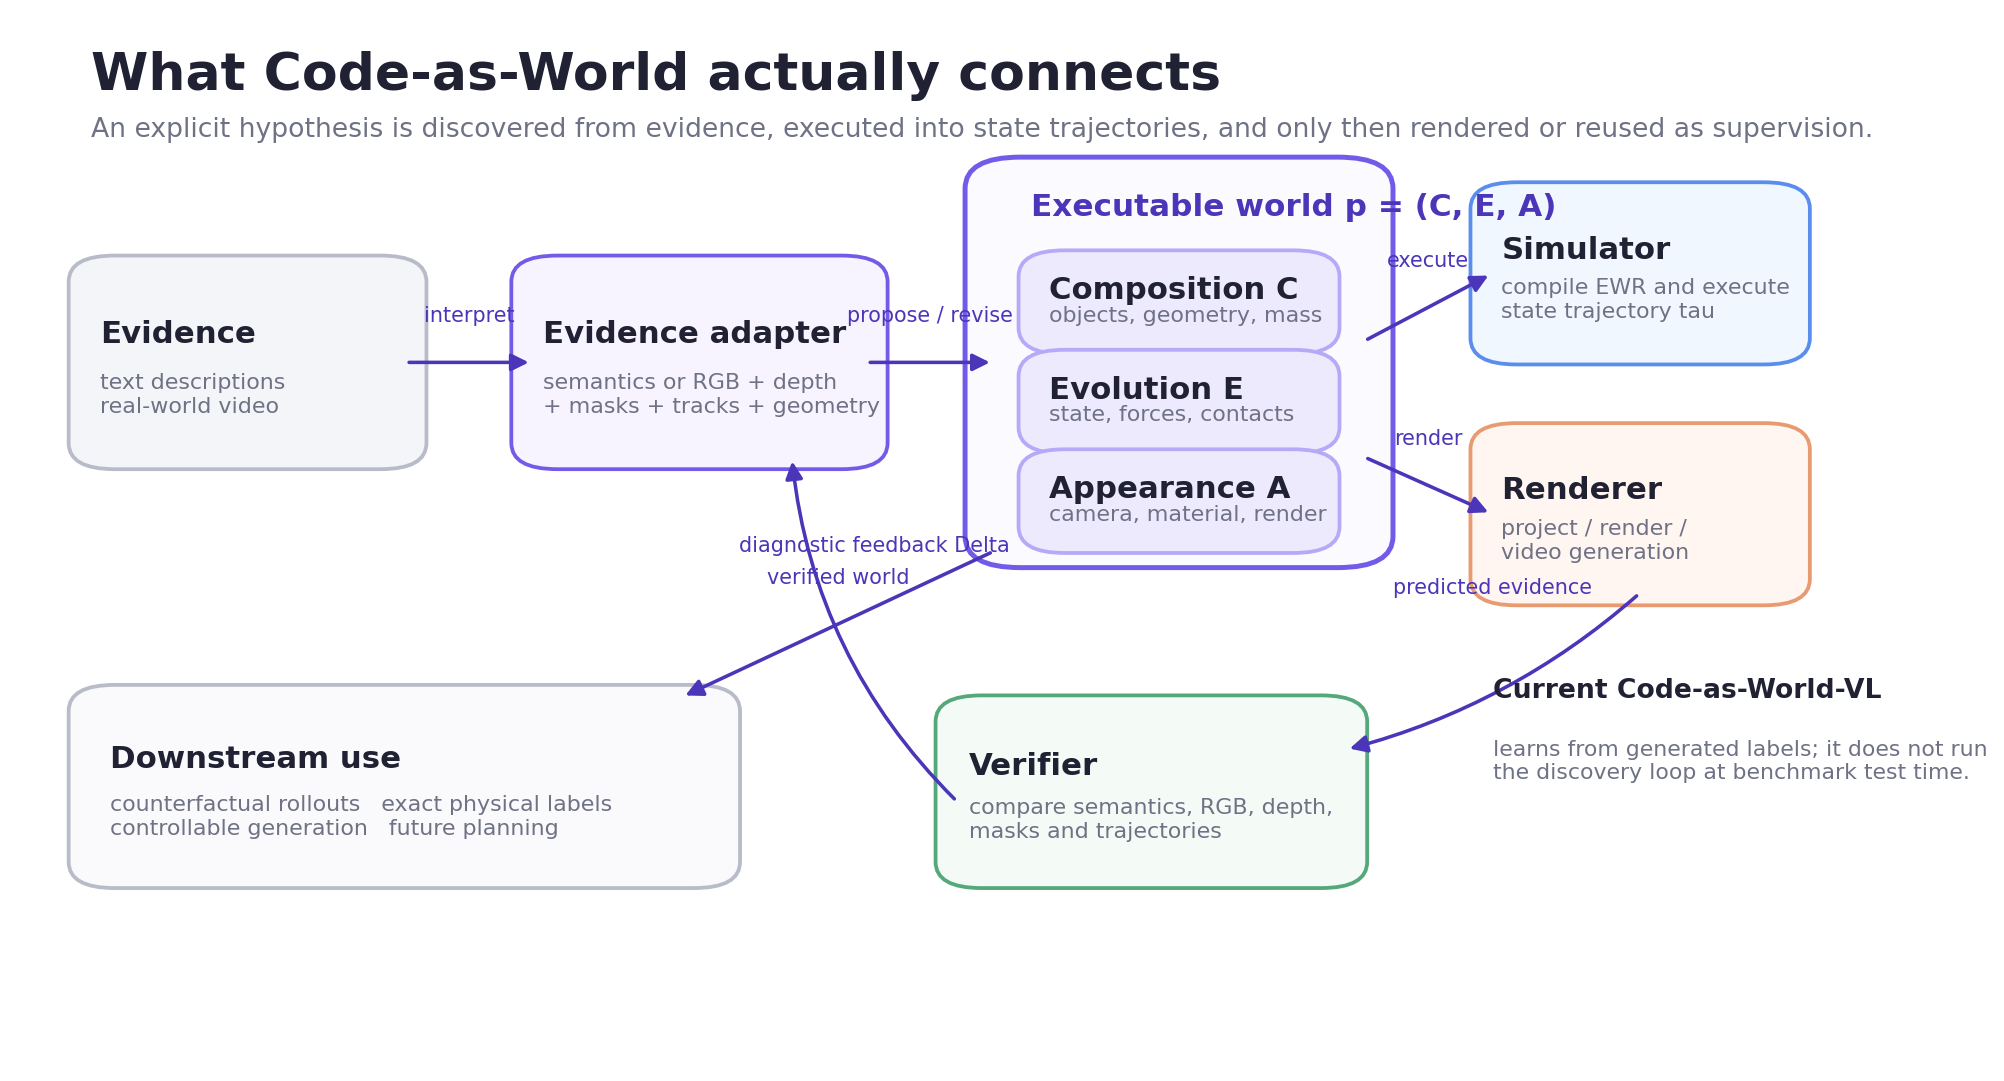
论文里的 code 包含结构化场景描述,也包含通往物理引擎的程序接口。它没有要求模型重新发明数值积分器。对象、初始状态和物理参数先写进 EWR,编译步骤再把它们转成特定模拟器能接受的参数。模拟器推进连续状态,renderer 把状态变回深度、mask、轨迹或像素。
一条简化后的正向路径可以写成下面几步。
p 是世界假说,θ 是模拟器参数,τ 是完整状态轨迹,η̂ 是模型预测出来的证据。执行把一组静态声明展开成了带时间的后果。对象会在何时接触,速度怎样改变,碰撞后走向哪里,都能从轨迹中检查。
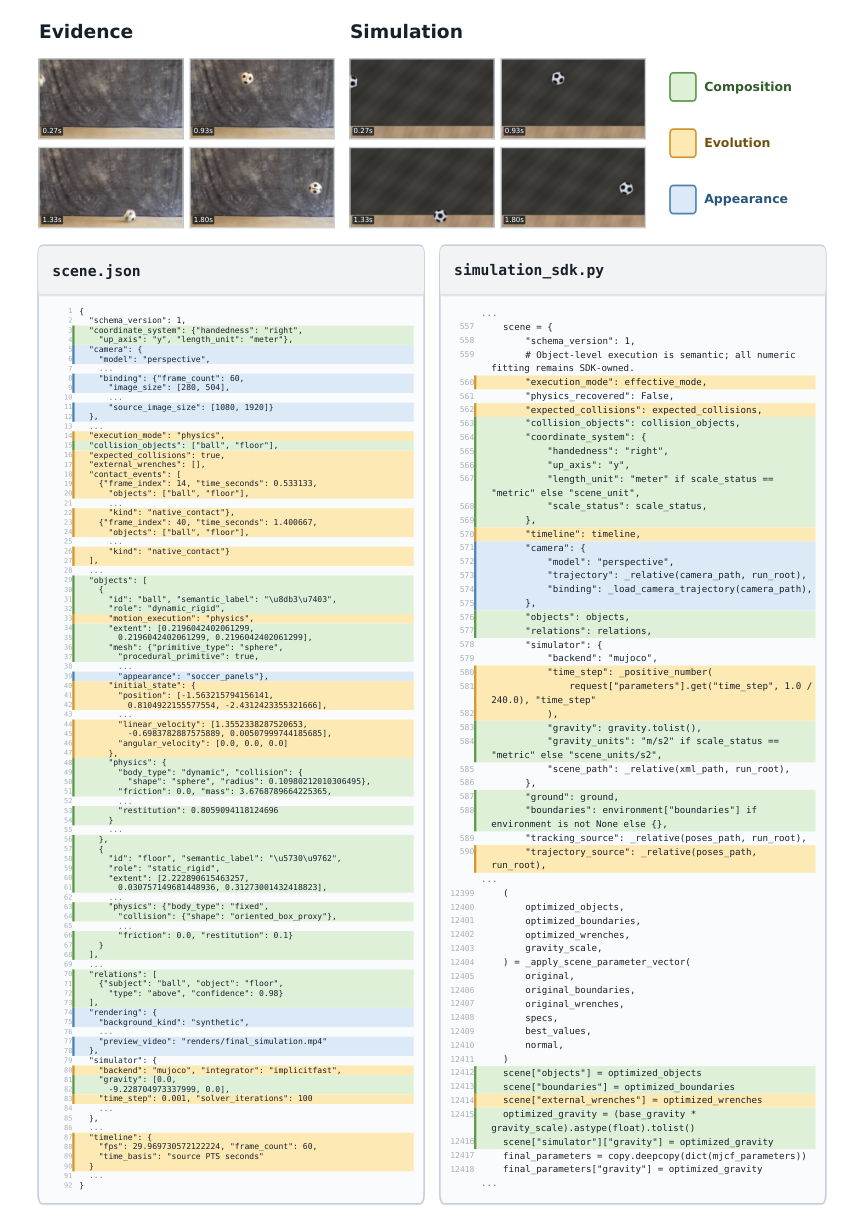
公开仓库里的足球案例给出了这种表示的具体形态。坐标系、米制单位、时间基准、球的初始位置与速度、碰撞半径、质量和恢复系数都被明确记录。渲染几何和碰撞几何还可以分开,前者服务外观,后者服务计算。它是一份声明式世界,运行以后才产生连续轨迹。
这里的连续状态并没有被离散文本消除。位置、速度和旋转仍然是浮点数组,mesh 与相机仍是高维对象。code 给它们命名,规定单位与关系,再把演化交给数值引擎。明确的语义边界和连续计算由此共存。
可执行让理解变成一项可检验的工作
一段自然语言可以把事件讲得很顺,却很难仅凭自身暴露参数错误。一个程序会给出后果。候选世界里的重力、初速度或相机位置有偏差,模拟轨迹和输入视频就会在相应位置分开。错误因此能被转成下一轮修订所需的信号。
从这个角度看,Code-as-World 对理解提出了更强的操作性要求。理解需要构造一个能够生成现有证据的世界,还要在改动条件以后给出一致后果。它接近科学建模中的溯因推理。研究者看见有限现象,提出一份相对简洁的机制假说,推导可观察结果,再让证据决定保留、修改或放弃。
下面这段动图来自公开足球案例。左侧是视频证据,右侧是 EWR 在 MuJoCo 中执行后得到的世界坐标轨迹。画面和轨迹承担不同任务。画面让人看见球,轨迹让系统读出某个时刻的位置与速度。
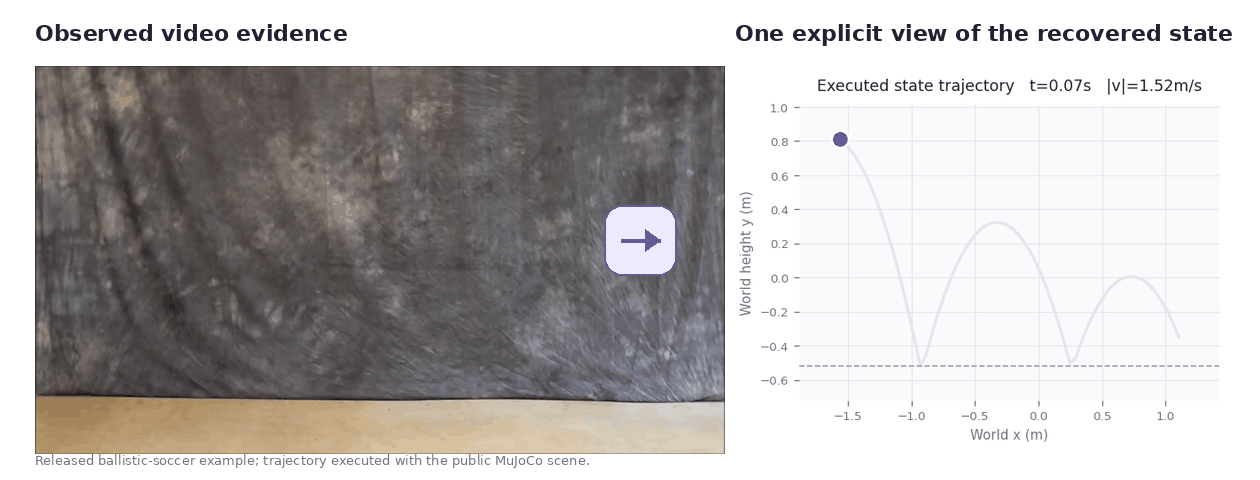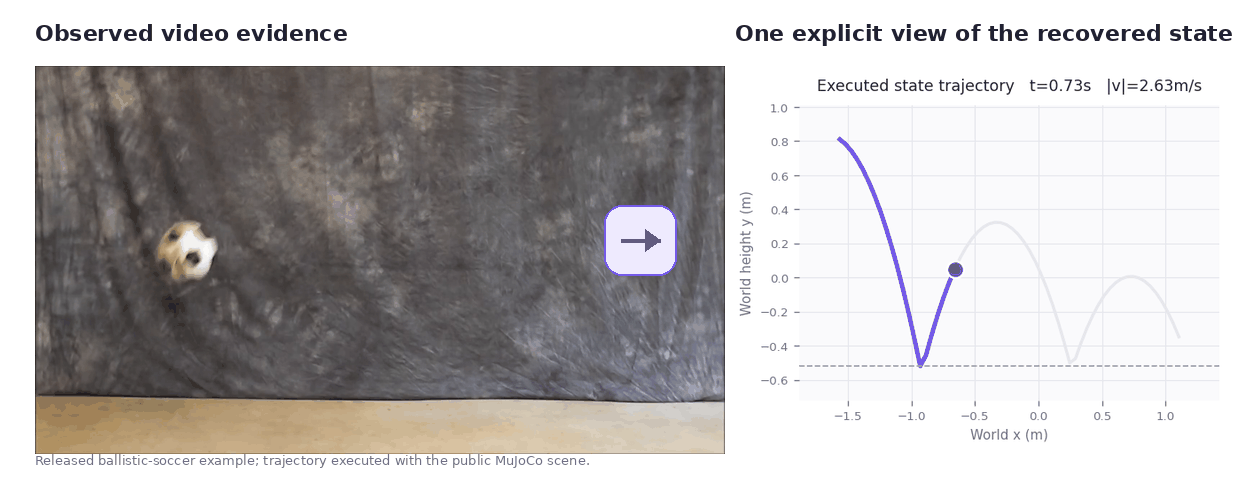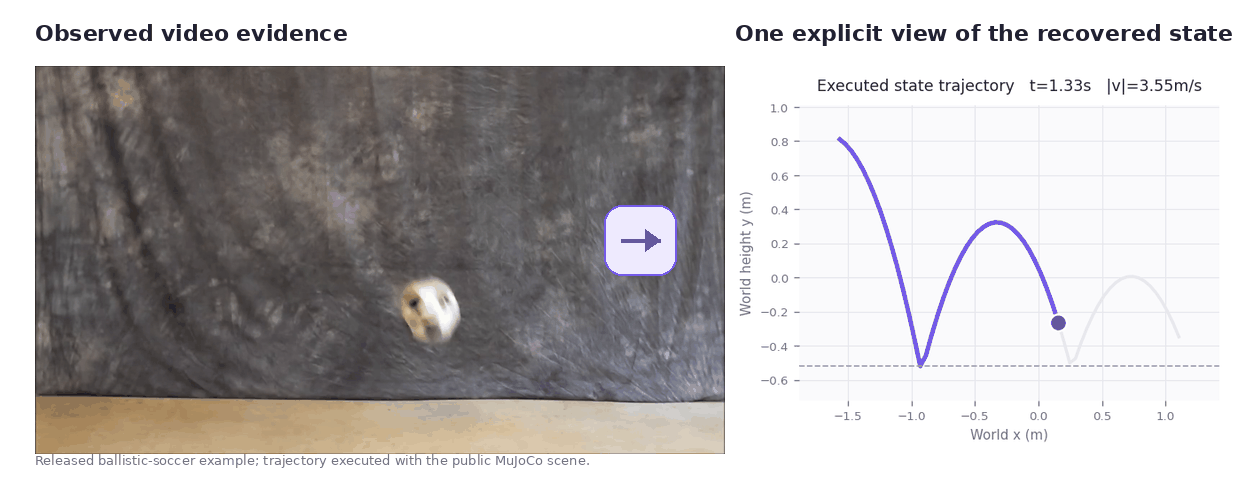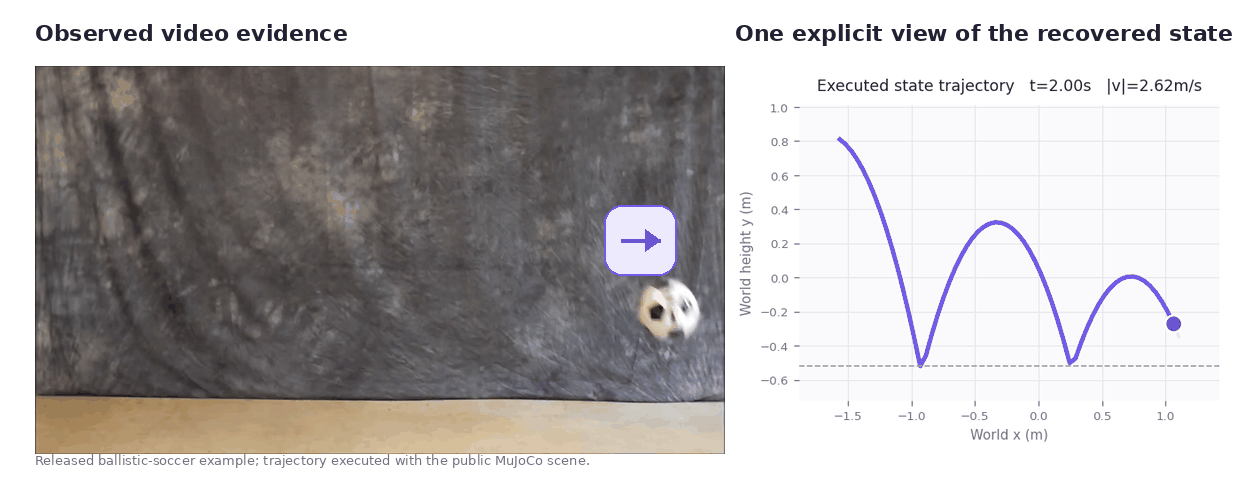
可执行还带来了介入能力。保持对象和环境不变,只修改初速度,系统可以重新运行;保留动力学,只更换相机,又能得到同一过程的另一个观察角度。这样的控制比提示视频模型生成一个近似场景更容易定位变量。每次改动作用在哪个字段,生成差异来自哪一层,都有明确记录。
Agentic discovery 怎样从观测找到世界
从 EWR 生成轨迹是正向问题,从视频恢复 EWR 是逆向问题。Code-as-World 把逆向恢复组织成一个循环。
文本输入先被整理为实体、空间关系、物理事件与预期结果。文字很少给出完整几何和相机参数,agent 会用先验与默认条件补齐候选世界。视频输入需要更多感知证据。系统用 instance mask 确定对象边界,用 track 保持时间对应,用深度和相机估计约束空间关系,再为对象构造三维 mesh。
这些证据进入同一条发现过程。agent 提议 EWR,把它实例化并执行,渲染出预测观测,再拿预测和输入比较。诊断结果 Δ_k 与上一轮假说一同送回下一轮。
论文把最大轮数设为五,并用相同计算预算下的 Best-of-5 做比较。Best-of-5 每次重新采样一份候选,发现循环会保留上一轮假说和诊断。第五轮在主要 animation engine 实验中改善了 Visual Alignment、Object IoU、Traj-ADE 和 Accuracy@2%D,Velocity-ADE 没有超过 Best-of-5。附录换用 physics engine 后,五项指标都在第五轮超过了 Best-of-5。
这个结果支持一个有限而重要的判断。带诊断的局部修订,比五次互不相关的猜测更有效。它还没有证明系统找到了唯一物理机制。模拟器与验证器已经规定了搜索空间,agent 在这套语言内部调整对象、参数和约束。发现循环会找出一份能够解释当前证据的世界,证据不足时,多份世界依然可能同时成立。
验证能排错,也会继承观测的歧义
验证器比较语义、RGB、深度、mask 与轨迹。报告还使用独立指标评价最后结果,减少发现过程直接迎合单一分数的风险。这项设计很重要,因为一个固定 verifier 很容易被系统学会取巧。
验证仍然没有消除不可辨识性。短视频中的一条抛物线,可能由多组重力、初速度、物体尺度和相机参数解释。深度估计偏差与碰撞参数也会互相补偿。一份候选 EWR 能够重现观测,只说明它暂时没有被证据排除。
模拟器失配带来另一类误差。真实接触会受细小几何、材料和地面变化影响。当前引擎若没有柔性、断裂或复杂摩擦,agent 可能用错误参数拟合出一条接近的轨迹。画面对上了,机制仍然可能偏。技术报告把这一点列为明确限制。
因此,我更愿意把最终输出理解为 world hypothesis,而非 world truth。一个成熟系统还应保留候选集合、参数不确定性和未决变量。新观测到来后,它可以选择最能区分候选的视角或动作。此时,验证从被动比较推进到主动 system identification。
世界代码怎样变成模型的物理监督
Code-as-World 的实证落点很克制。研究者没有要求 VLM 在测试时生成 EWR,也没有让它在线调用模拟器。通过验证的世界先用于构造训练数据,模型随后学习定量物理问答。
训练分成两个阶段。第一阶段建立 image-space measurement。RefCOCO 系列和 RefCLEF 提供物体描述与框,GOT-10K 提供密集轨迹。系统把这些标注改写成宽度、位置、位移、速度和加速度问题,共得到 73,335 个问答,其中 46,763 个来自 GOT-10K。模型先学会找对对象、读出像素尺度,并维持跨帧对应。
第二阶段建立 world-space calibration。通过验证的 EWR 同时给出视频、对象尺度和完整状态轨迹。尺寸可以从几何读取,位移、速度与加速度可以从轨迹计算。世界级监督包含 1,585 个文本驱动样本和 988 个视频驱动样本,总量 2,573。
从像素量换到现实单位依赖尺度标定。参考物体在现实中的量为 ρ,它在图像中的测量为 ρ_pix,目标的图像测量为 y_pix,换算关系如下。
公式很短,模型还要做不少工作。它得找到正确的参考物和目标,读准指定时间,跟踪运动,处理透视和深度,再把单位写对。这一换算还依赖基准给出的参考量和相应投影条件,不能直接当成任意单目视频的通用绝对尺度恢复。第一阶段教测量,第二阶段教标定,两部分缺一都会让最终数字失去依据。
生成在这套训练里有两个清楚的用途。模拟执行生成带精确标签的状态轨迹,视频生成器再把模拟过程改写成更接近真实分布的观测。状态标签仍由 EWR 和 simulator 决定,外观模型负责物体材质、背景与光照。报告里的 sim-to-real 指标显示,生成视频在 JEDi 与 TRAJAN 上更接近真实视频分布,几项运动保真指标大体接近模拟渲染,其中 Velocity-ADE 和 Accuracy@2%D 略有退步。外观迁移有收益,也留下了可量化的偏差。
这些结果说明了多少
QuantiPhy 要求模型从单目视频估计物体尺寸、位移、速度和加速度。评测在十个相对误差阈值上分别给分,再对四个子集做宏平均,最后乘以一百展示。55.4 不能读作 55.4% 的题目答对。技术报告给出的主要结果很醒目。
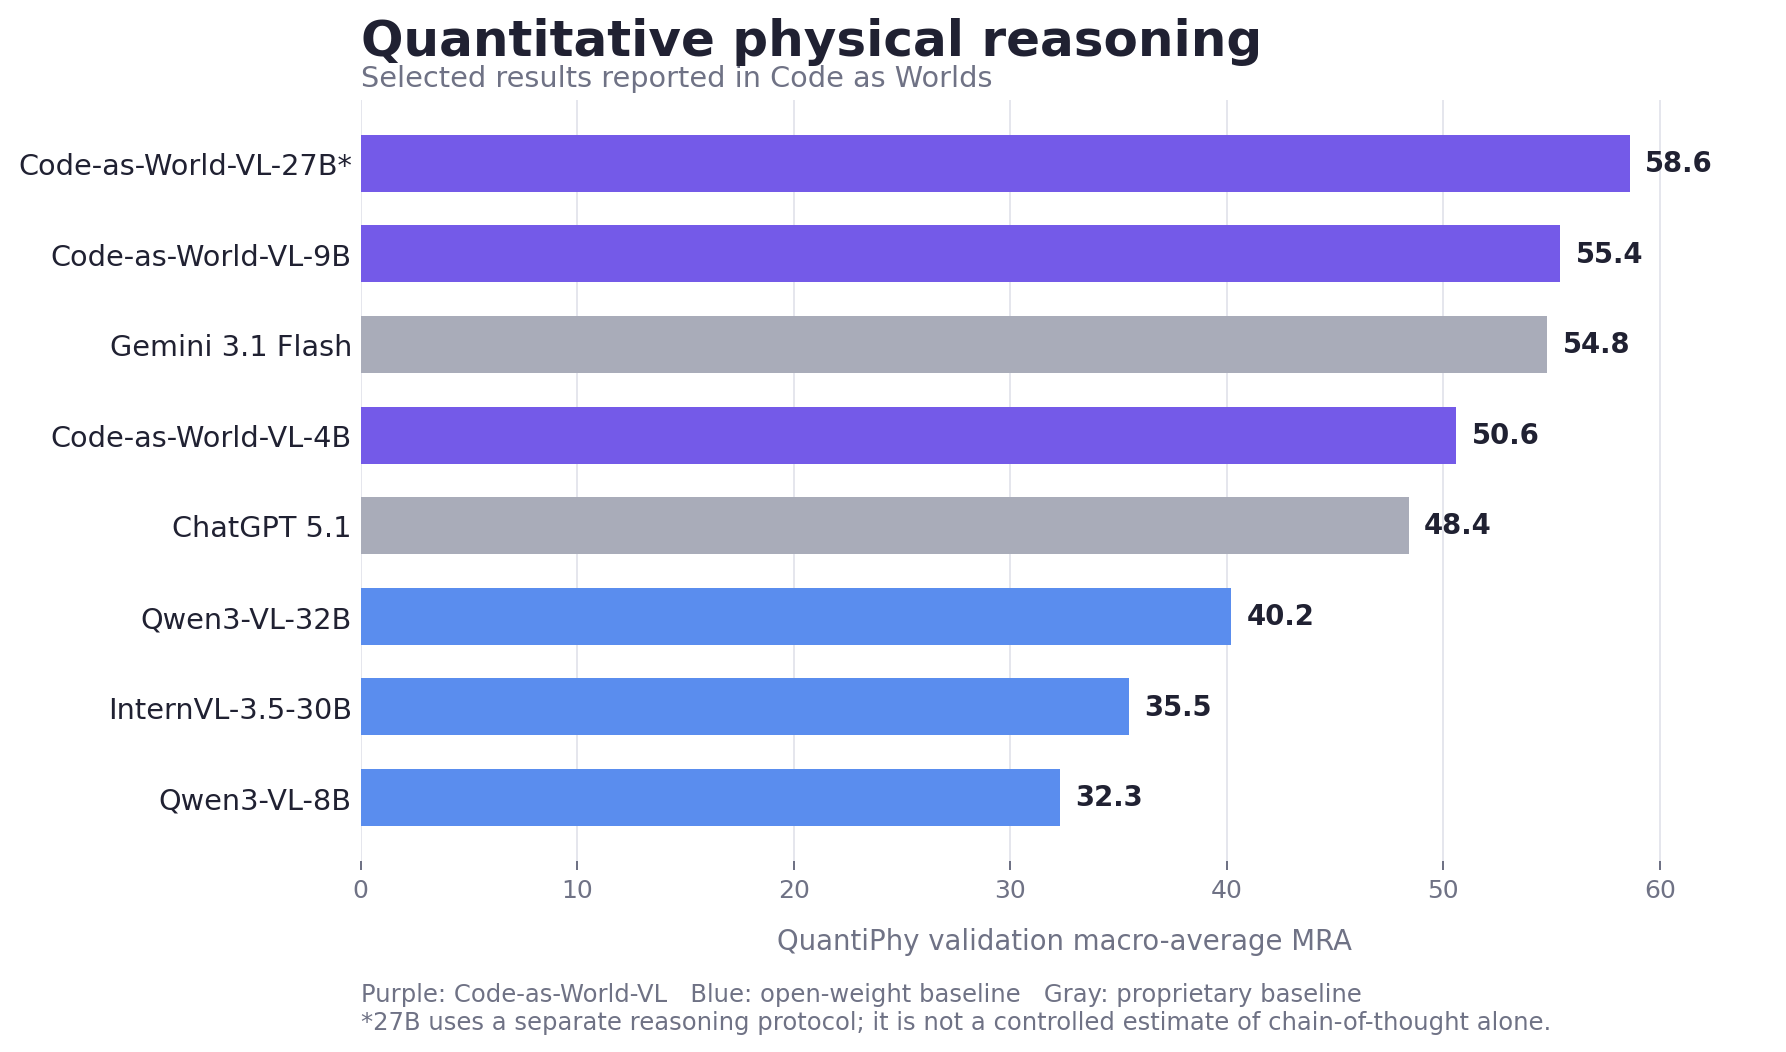
4B 模型得到 50.6,9B 得到 55.4。9B 的直接回答版本在这套协议下超过报告列出的 Gemini 3.1 Flash 54.8。27B reasoning variant 达到 58.6。27B 同时改变了模型规模和回答协议,论文也明确提醒,58.6 只能说明方法能够扩展到更大的 reasoning model,无法单独估计 reasoning trace 带来的增益。
数据消融更能解释世界监督的作用。
| 训练数据 | 4B 平均 MRA | 9B 平均 MRA |
|---|---|---|
| 仅 Image-Space | 44.2 | 50.9 |
| 加入 text-driven worlds | 48.5 | 52.5 |
| 加入 video-driven worlds | 47.8 | 53.1 |
| 三类数据合并 | 50.6 | 55.4 |
两类世界数据单独加入都有增益,合并结果最好。文本世界提供干净、精确的物理状态,视频世界保留真实观测里的外观与运动分布。二者共同补充 image-space grounding。这里还有一处值得记下的报告细节。附录表四、主表和项目页都给出 9B 完整模型为 55.4,表后文字写成了 56.8。本文采用三处一致的 55.4。
这些数字支持 verified executable worlds 是一种有效的定量监督来源。它们尚未证明 VLM 学会了构造或维护世界代码。测试时,4B、9B 和 27B 都只接收视频帧、问题与基准提供的物理先验。它们看不到生成样本时使用的 EWR,也不调用发现循环。
结论还受评测范围约束。QuantiPhy validation 共有 159 个问答,主要考察受控运动下的单目尺度标定。复杂接触、旋转、形变、遮挡、流体与长时多物体动力学没有被主结果覆盖。较小而贴近训练目标的世界级数据取得明显增益,这很有启发,也需要更多跨基准与分布外实验确认泛化。
Code、语言、latent 与 simulator 各自留下来
把 Code-as-World 读成纯符号路线,会错过它最现实的一点。系统没有摆脱 latent,也没有让 code 独自承担感知和生成。它做的是分工。
| 部分 | 在系统中的工作 |
|---|---|
| Latent 表征 | 保存难以命名的视觉细节,提供感知先验与相似性 |
| 自然语言 | 连接对象语义、常识、定性因果与人的指令 |
| Code | 保存可命名状态、单位、约束和可干预参数 |
| Simulator | 按给定机制推进连续状态并产生轨迹 |
| Renderer 与生成模型 | 把状态变成可观察证据和丰富外观 |
| Verifier | 比较预测与输入,把差异转成修订信号 |
这套分工让世界状态从模型内部走到一个共享接口上。agent 可以修改质量或相机,模拟器能执行改动,验证器也知道应当比较哪类后果。与此同时,表示的 schema 会决定系统能看见哪些问题。schema 里没有材料疲劳、柔性形变或人的意图,agent 就很难只靠多想几轮补出这些因素。
更可行的长期形态大概是 hybrid world state。显式部分保存对象、关系、单位与已知约束,latent 部分处理外观、复杂接触和暂时无法命名的残差。系统还要判断当前该调用哪一类 simulator,什么时候承认已有引擎无法解释证据。code 提供清楚的干预位置,latent 保留开放世界覆盖,两者之间需要持续校准。
它和 Physical RSI 之间隔着什么
MirroS 把 Code-as-World 放进一条更长的 Physical RSI 路线。那条路线设想 agent 在现实中遇到意外,区分 world model 的缺口和 actor 的能力缺口,把未解释事件抽象成可复现环境,找到应对策略,再回到现实验证并内化经验。
Code-as-World 已经实现其中一个局部环节。它在单条样本内提出假说、执行、比较并修订。Physical RSI 还要求系统跨经历保存知识,让一次修订改变下一次理解,并让 actor 与 world model 相互推动。这类持续内化、跨场景迁移和现实回归测试没有出现在当前实验里。
两者的尺度差异很关键。论文中的 evolve 指一条样本最多五轮的 hypothesis refinement。Physical RSI 讨论的是长期学习,系统要处理不断到来的 OOD 事件,扩展表示语言与技能,并防止新知识破坏旧能力。把前者直接称作自进化智能,会让已经完成的工作和研究愿景混在一起。
从流式视频研究看,我更关心 EWR 能否成为一种有界的长期状态。原始帧会不断累积,视觉 token 也会随时间增长,语言摘要常丢掉几何和度量。一个在线系统可以保留当前世界假说,只在新证据到来时更新相关对象和参数。
这条路线随后会遇到难题。新证据与旧假说冲突时,系统要判断该调参数、加对象,还是更换物理机制。在线计算还受时间预算限制,无法对每段新视频完整运行五轮发现。若 EWR 真能承担长期状态,它应当在未来不可见的协议下减少重算,并在对象重现、远距离因果和量化查询上优于同预算的 token memory。这是一组可以直接做实验的问题。
哪些实验会让我更相信这条路线
第一组实验应当处理多解。系统可以输出多份仍被证据支持的 EWR,给参数分布和结构候选分配置信度。新视角或新动作到来后,候选集合应当正确收缩。单点答案的拟合分数再高,也很难说明不确定性是否可靠。
第二组实验需要让行动参与发现。被动视频只包含别人已经完成的动作。具身 agent 可以移动相机,轻推物体,改变支撑条件,并选择最能区分候选机制的一次试验。EWR 已经给出了可干预接口,active perception 可以检验它有没有确实用于 system identification。
第三组实验要正面处理 simulator misspecification。系统应当识别当前 engine class 覆盖不了的现象,保留显式守恒与几何约束,同时让 learned residual dynamics 拟合未建模部分。若每次失配都靠调一个错误参数吸收,世界代码会越来越像对单条视频的过拟合。
第四组实验才轮到把 discovery 内化进模型。模型可以直接预测 EWR patch,选择验证工具,根据执行反馈改动局部状态。评测也应拆开可运行率、机制正确性、干预外推和跨场景复用。最终答案正确只能覆盖这条链中的最后一步。
我最后留下的判断
Code-as-World 最有价值的贡献,是把物理理解变成了一件可以运行的事。候选世界会产生轨迹,轨迹会变成观测,观测差异会回到下一轮修订。理解由此拥有了明确的失败位置。
这些限制没有削弱核心问题。它们把下一步实验写得更具体。一个智能系统若想在开放世界里积累物理经验,需要维护能够被新证据修订的世界状态。code 提供了一种外显形式,模拟器让它产生后果,验证器负责让现实参与判断。Code-as-World 已经证明这条链能够产生有用监督。它能否进一步成为模型在推理时主动维护的世界表示,仍要由更广的现象、更强的干预实验和长期状态更新来回答。