 2026
CVPR 2026
Wavelet-based Frame Selection by Detecting Semantic Boundary for Long Video Understanding
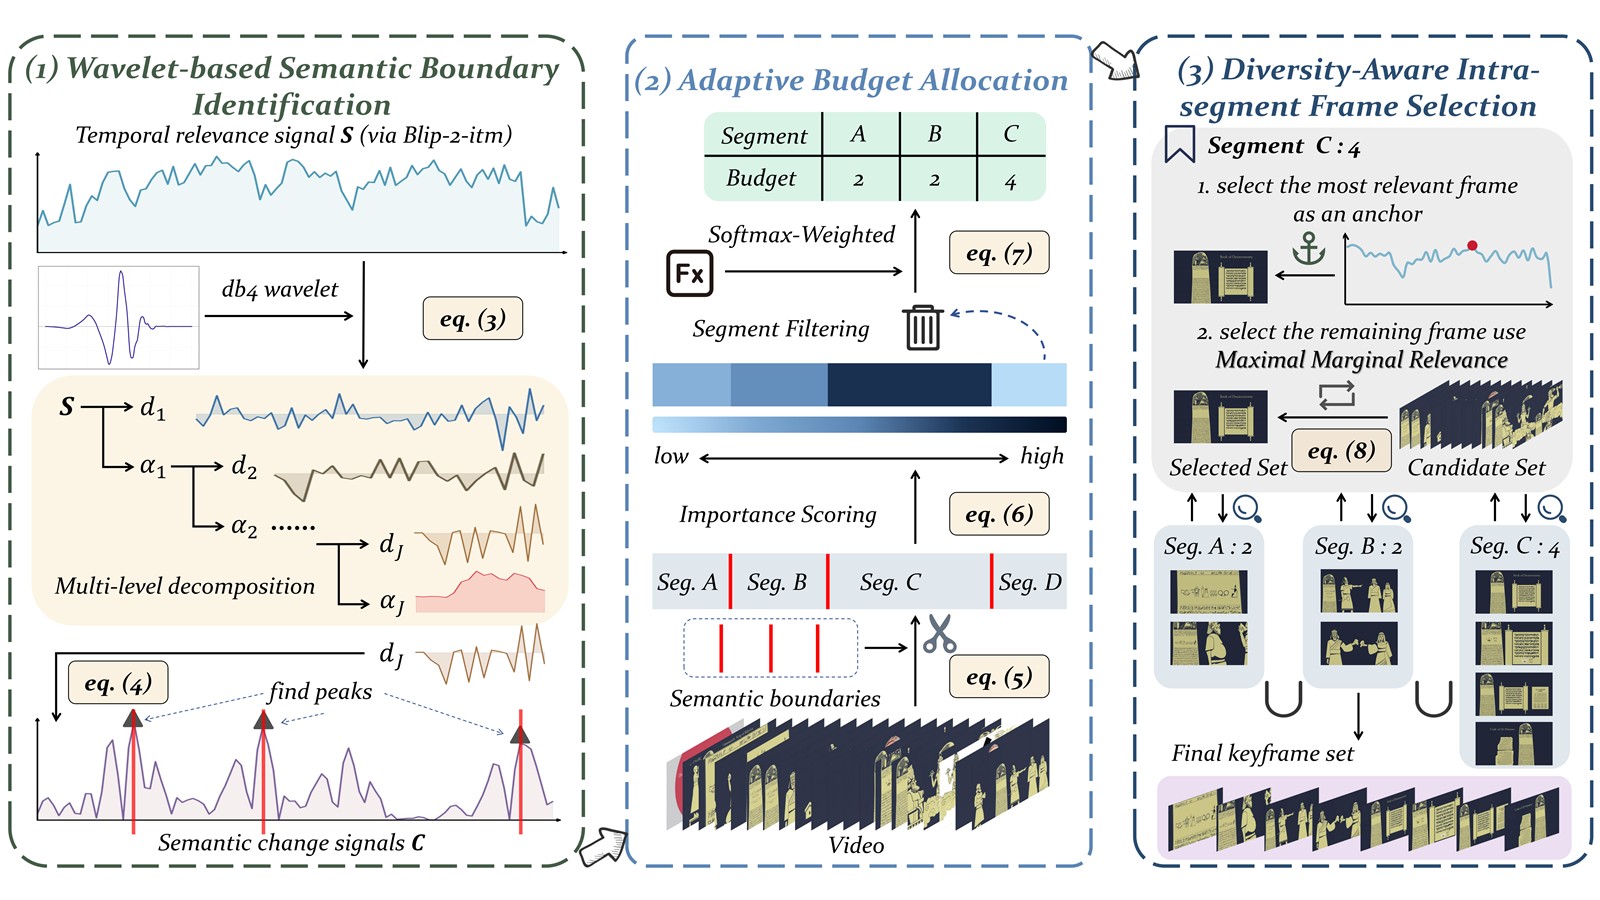
从有噪声的查询-帧相关性信号中检测语义边界,再按片段重要性分配帧预算。方法无需训练,在 VideoMME、MLVU 与 LongVideoBench 上分别提升 5.5、9.5 与 6.2 个百分点。
Publications
2026CVPR 2026
从有噪声的查询-帧相关性信号中检测语义边界,再按片段重要性分配帧预算。方法无需训练,在 VideoMME、MLVU 与 LongVideoBench 上分别提升 5.5、9.5 与 6.2 个百分点。
 2026
AAAI 2026 · Equal contribution
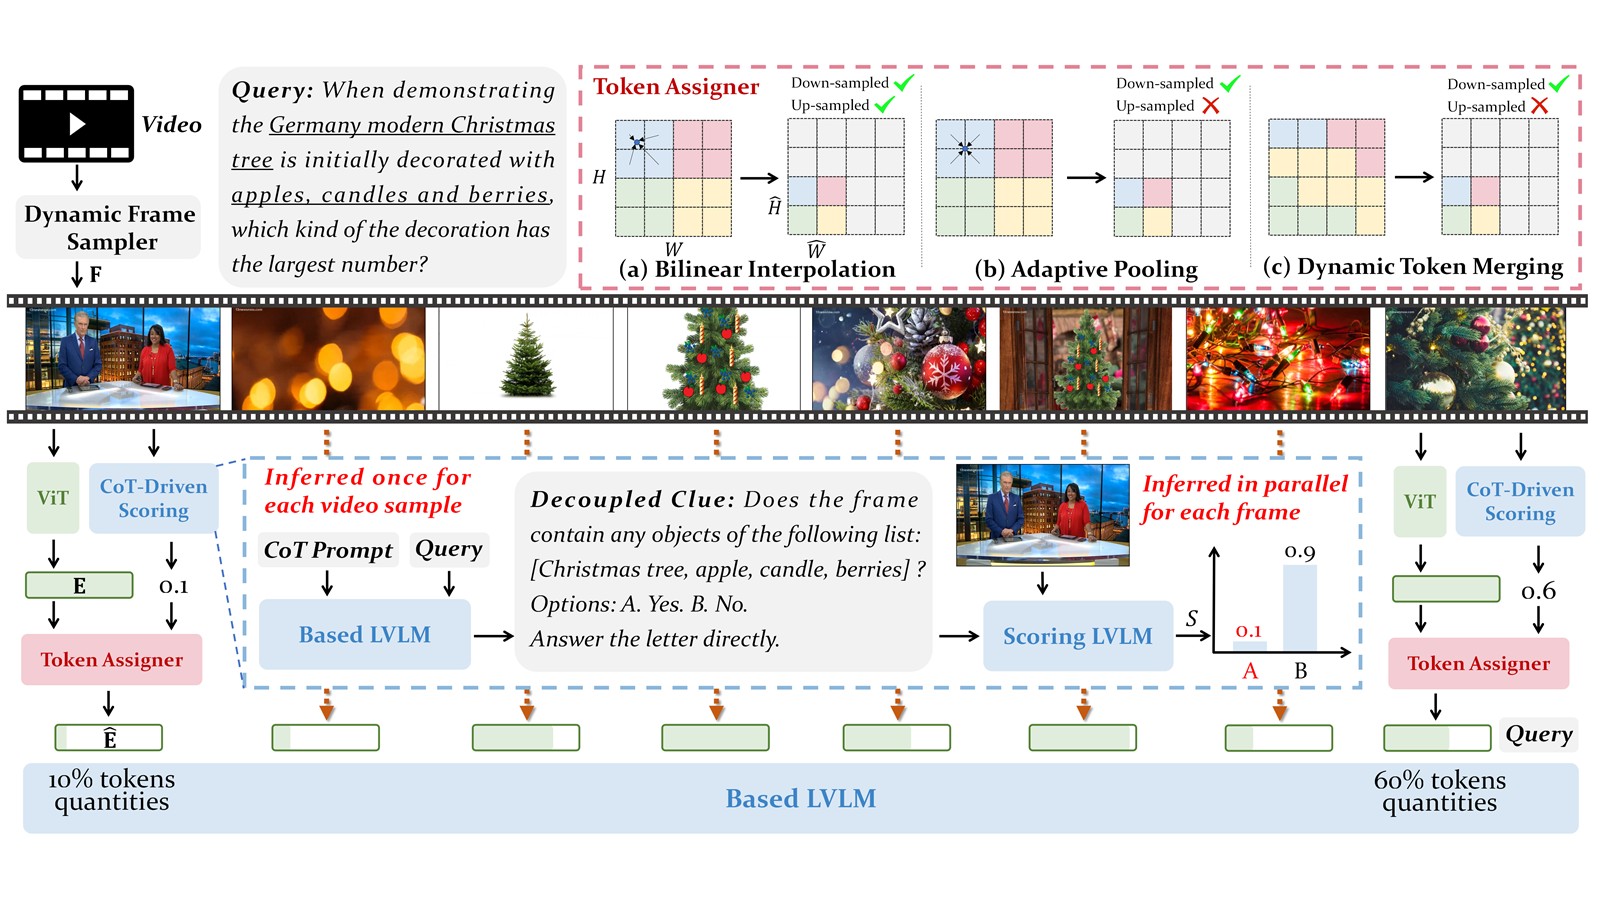
在跨模态交互前,根据查询对各帧分配视觉 token。CoT 将复杂问题拆成可判定线索,同等 token 预算下在六个视频基准上平均提升 3.2 个百分点。
 2023
ICASSP 2023 · Equal contribution
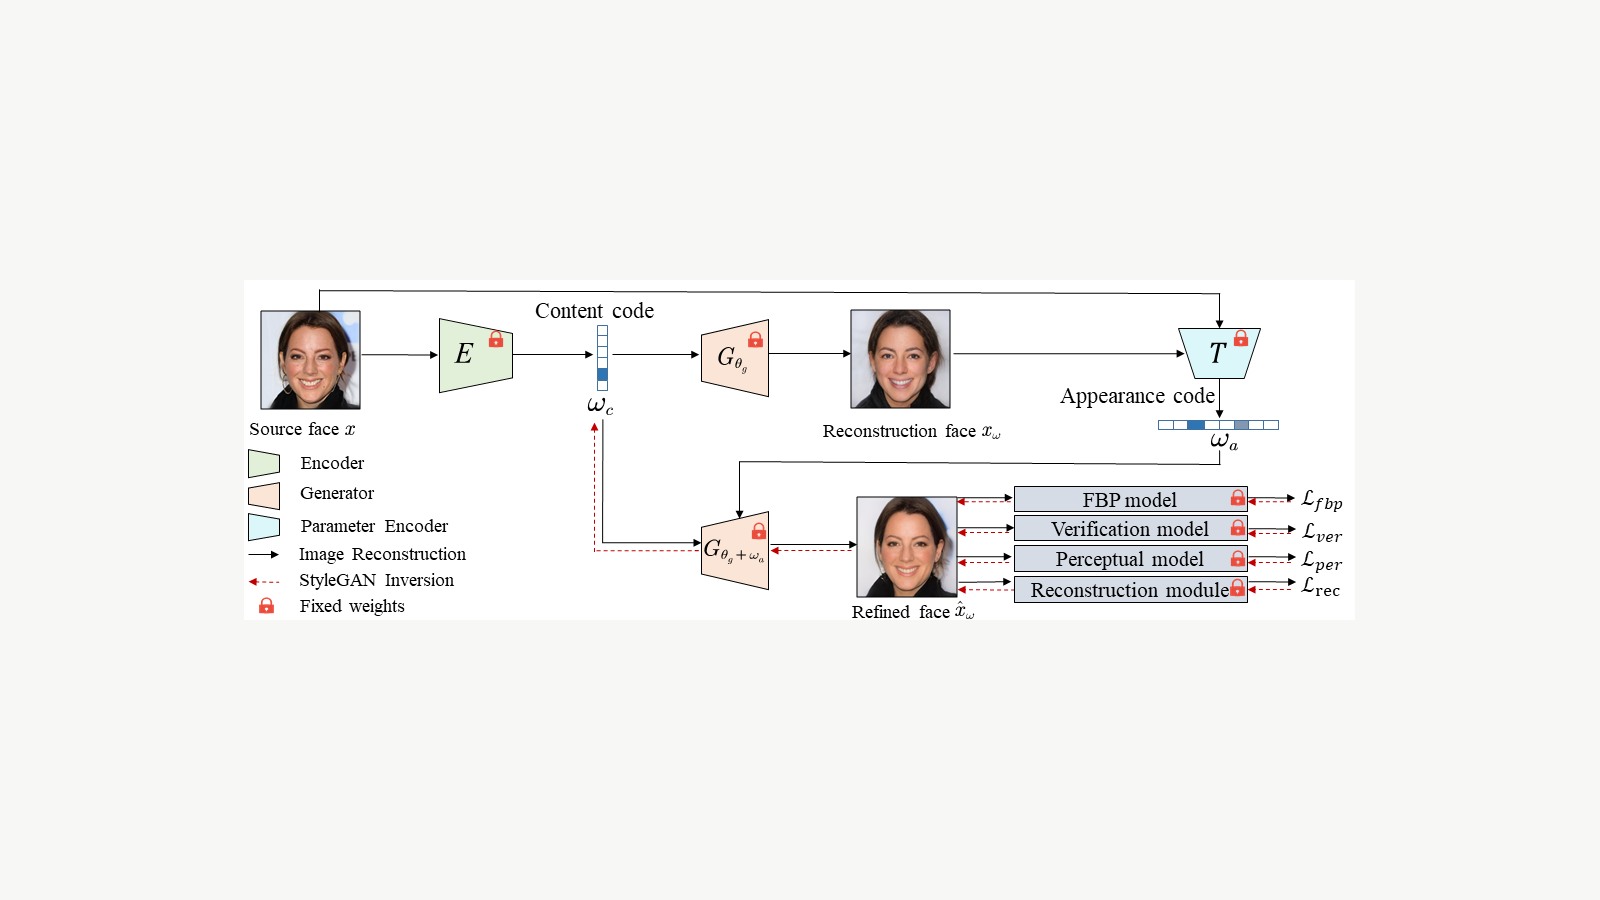
提出由人脸美学预测模型引导的 StyleGAN 反演,根据用户给出的目标分数做定制化人脸修饰,同时尽量保留身份信息。
 2026
ICML 2026
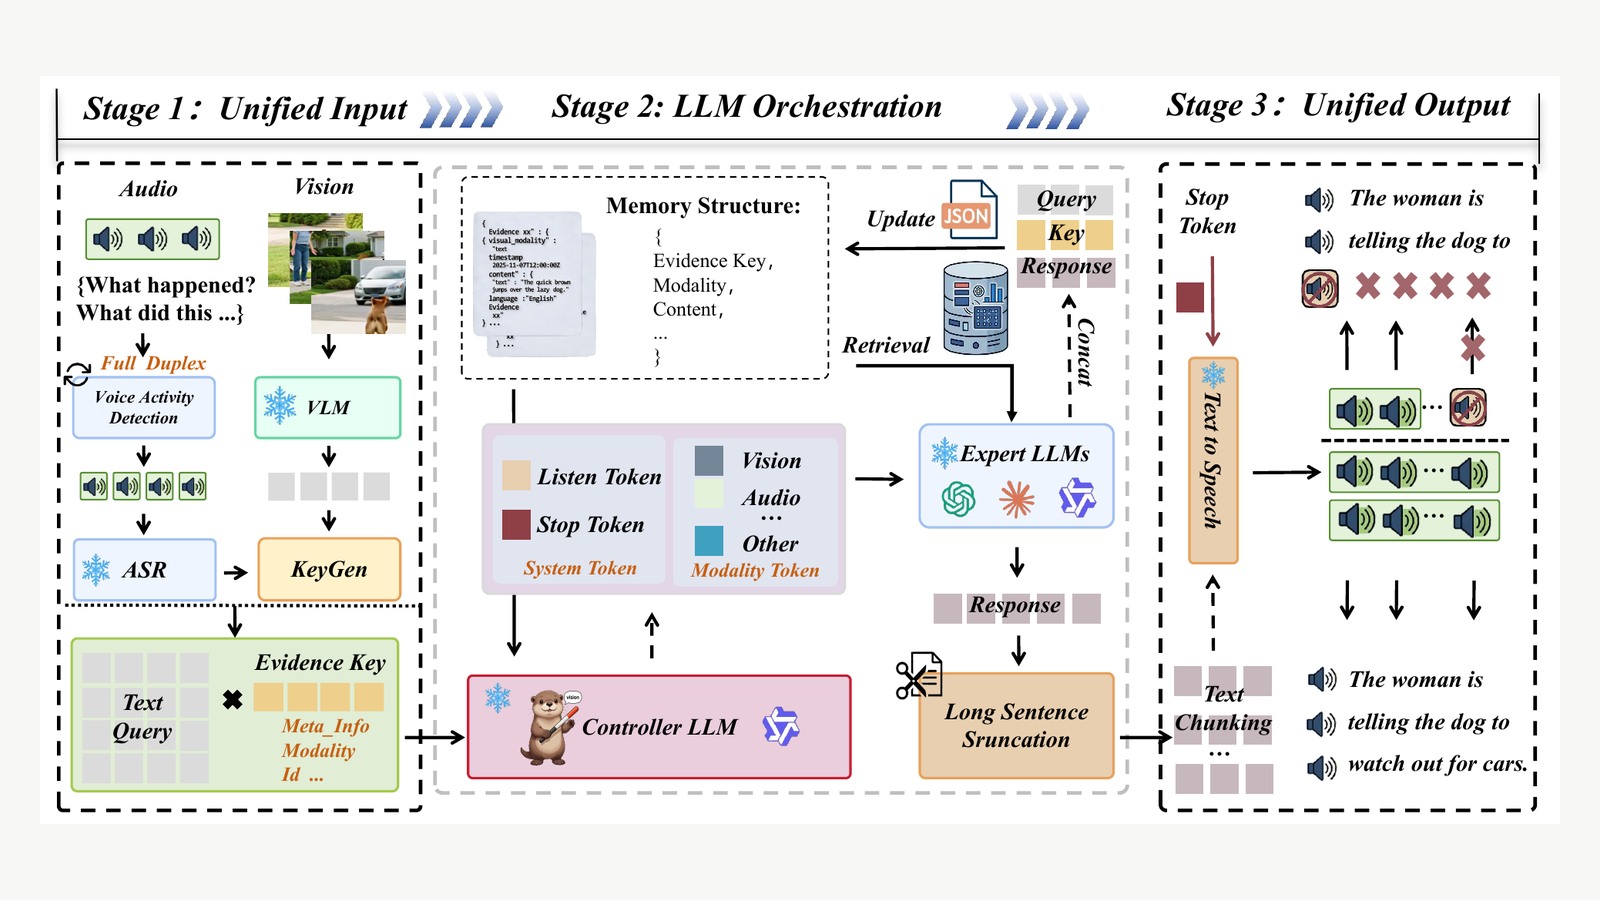
通过语言模型控制器、文本化跨模态记忆和全双工交互层,在不额外训练的情况下组合现成的模态专家。
 2026
arXiv preprint · Equal contribution
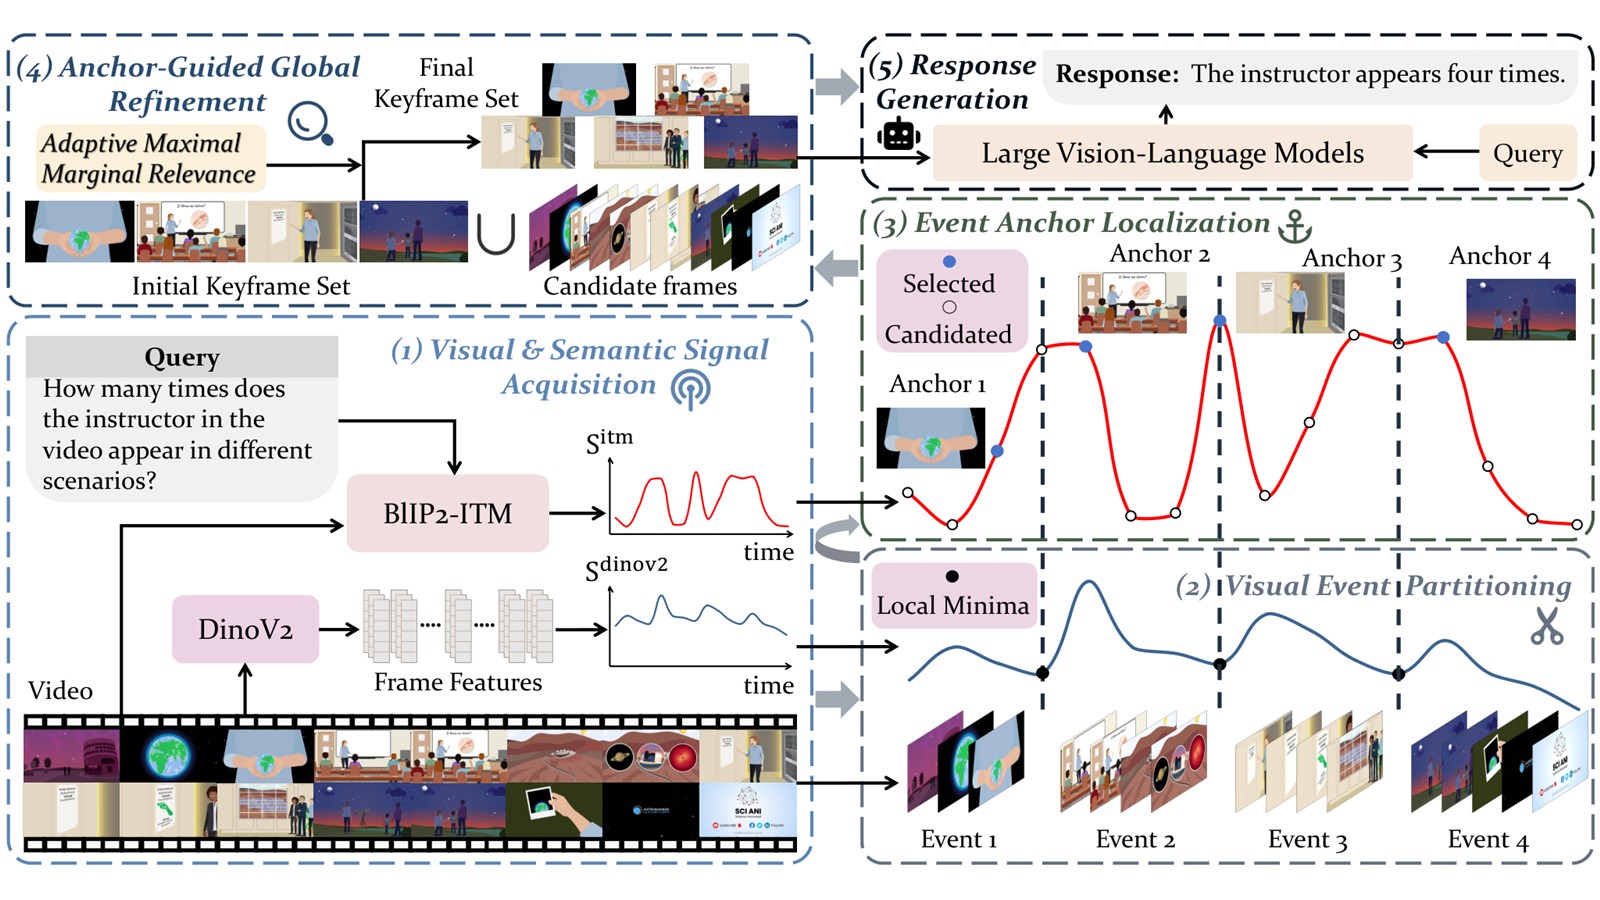
先把视频划成视觉一致的事件,再为每个事件定位查询相关锚点,最后用自适应 MMR 做全局补充,在覆盖、相关性和多样性之间取得平衡。
 2024
SSRN preprint
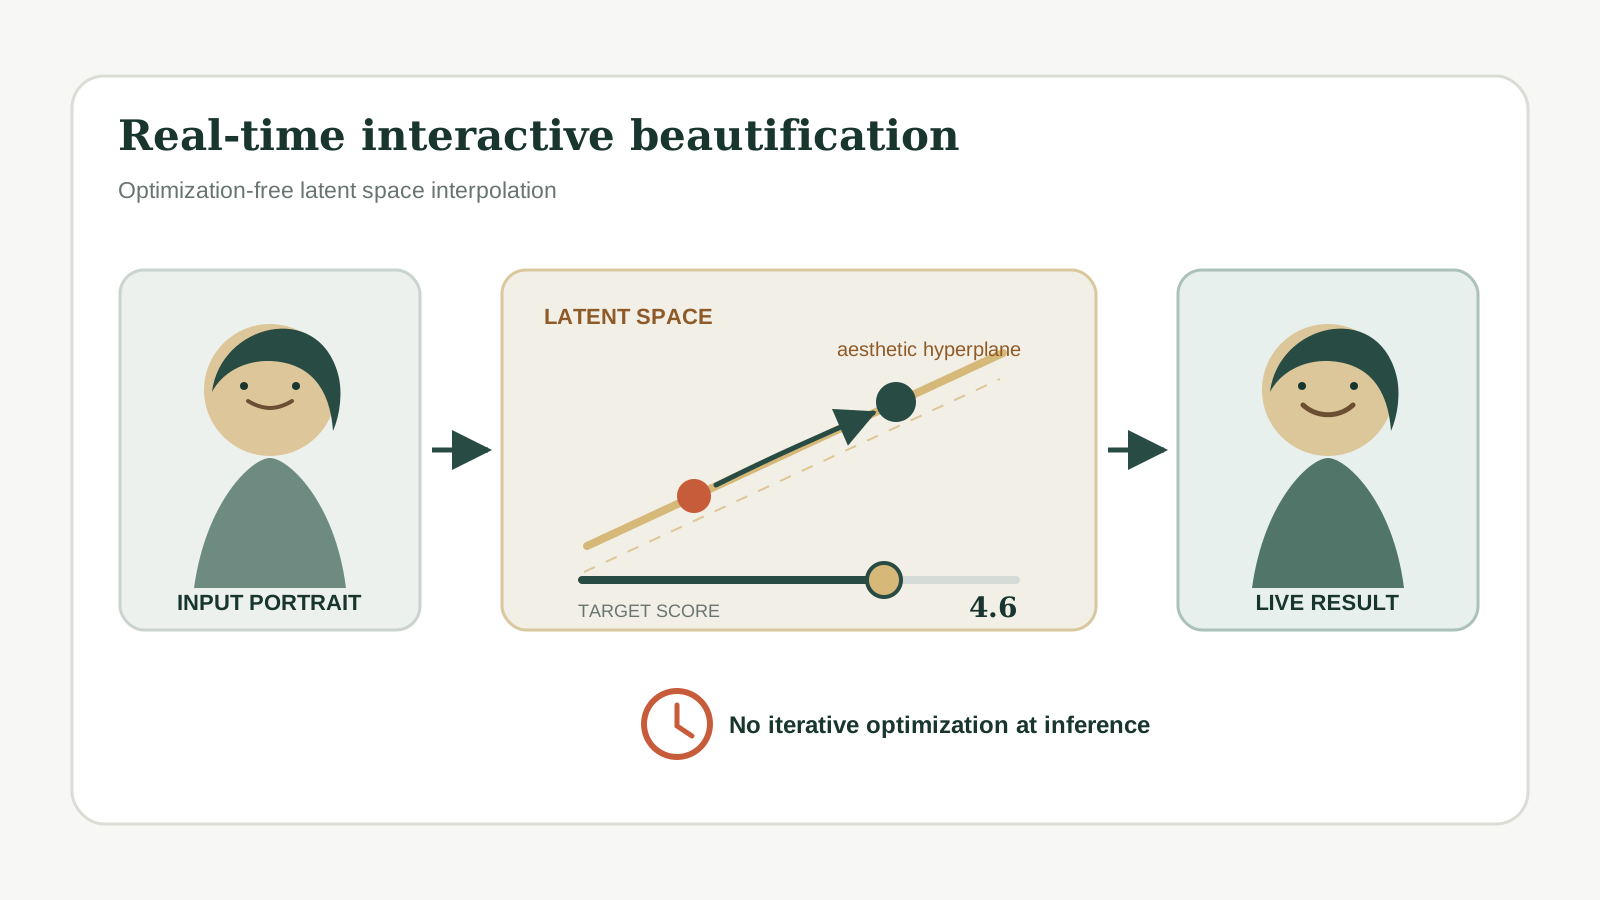
构造美学超平面,并在潜空间中直接插值,使用户可以实时调整目标美学分数,同时尽量保留身份特征。
 2026
arXiv preprint
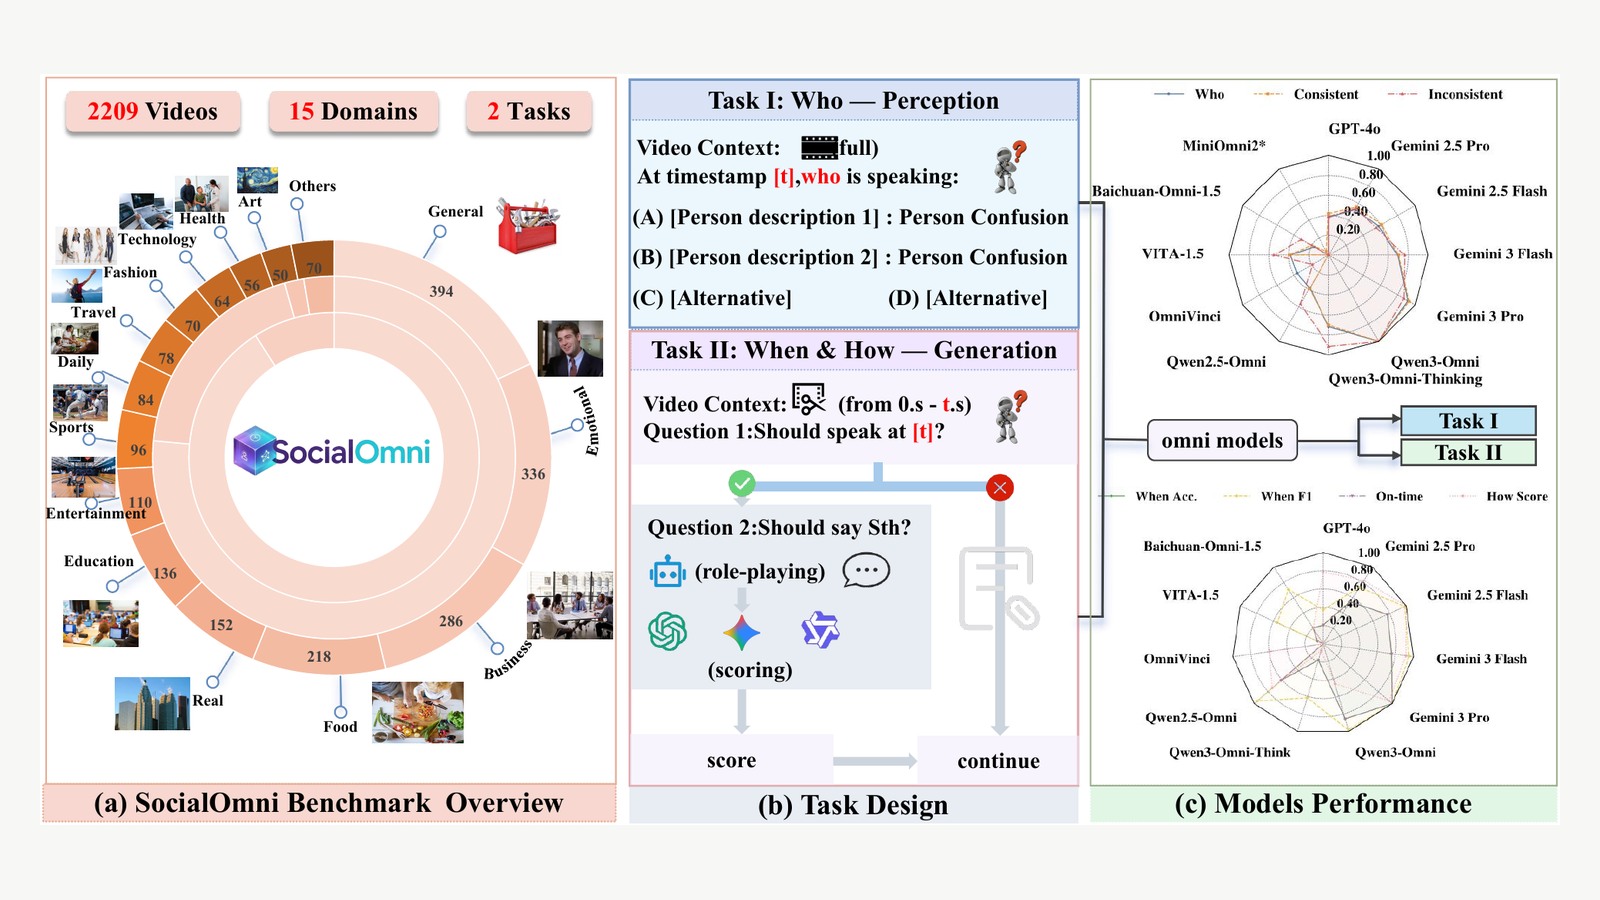
从说话人感知、打断时机与回应方式评测音视频社交交互,并分析感知准确率与最终交互质量之间的差距。
 2026
arXiv preprint
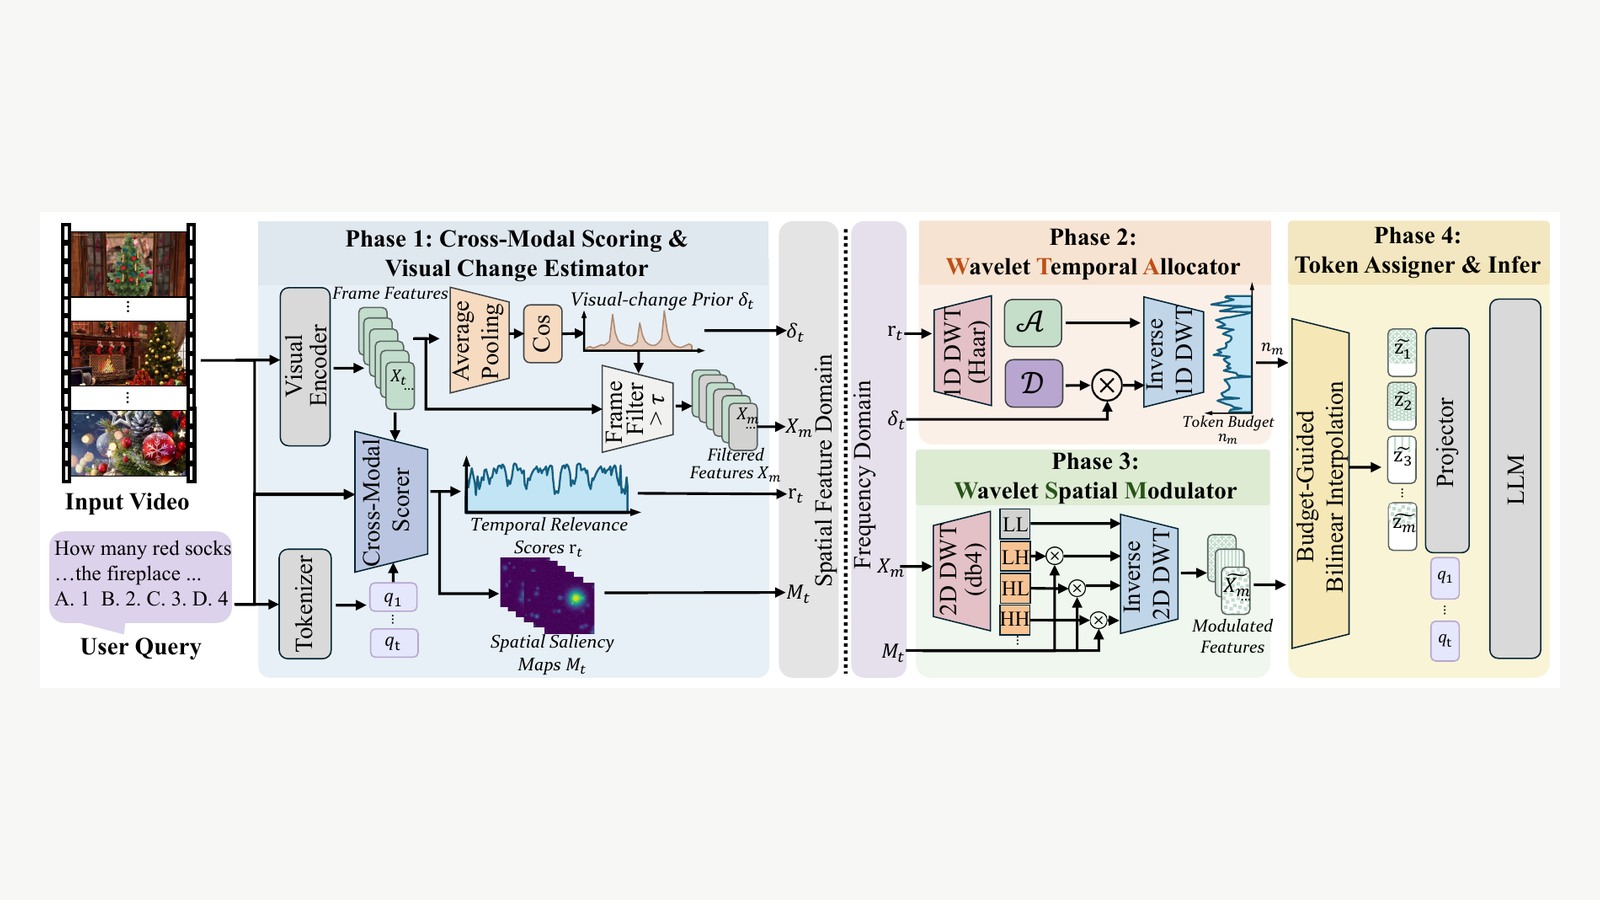
用时空解耦的小波分析分配帧级预算并压缩空间 token,关注高压缩率下的性能保留。
 2026
arXiv preprint
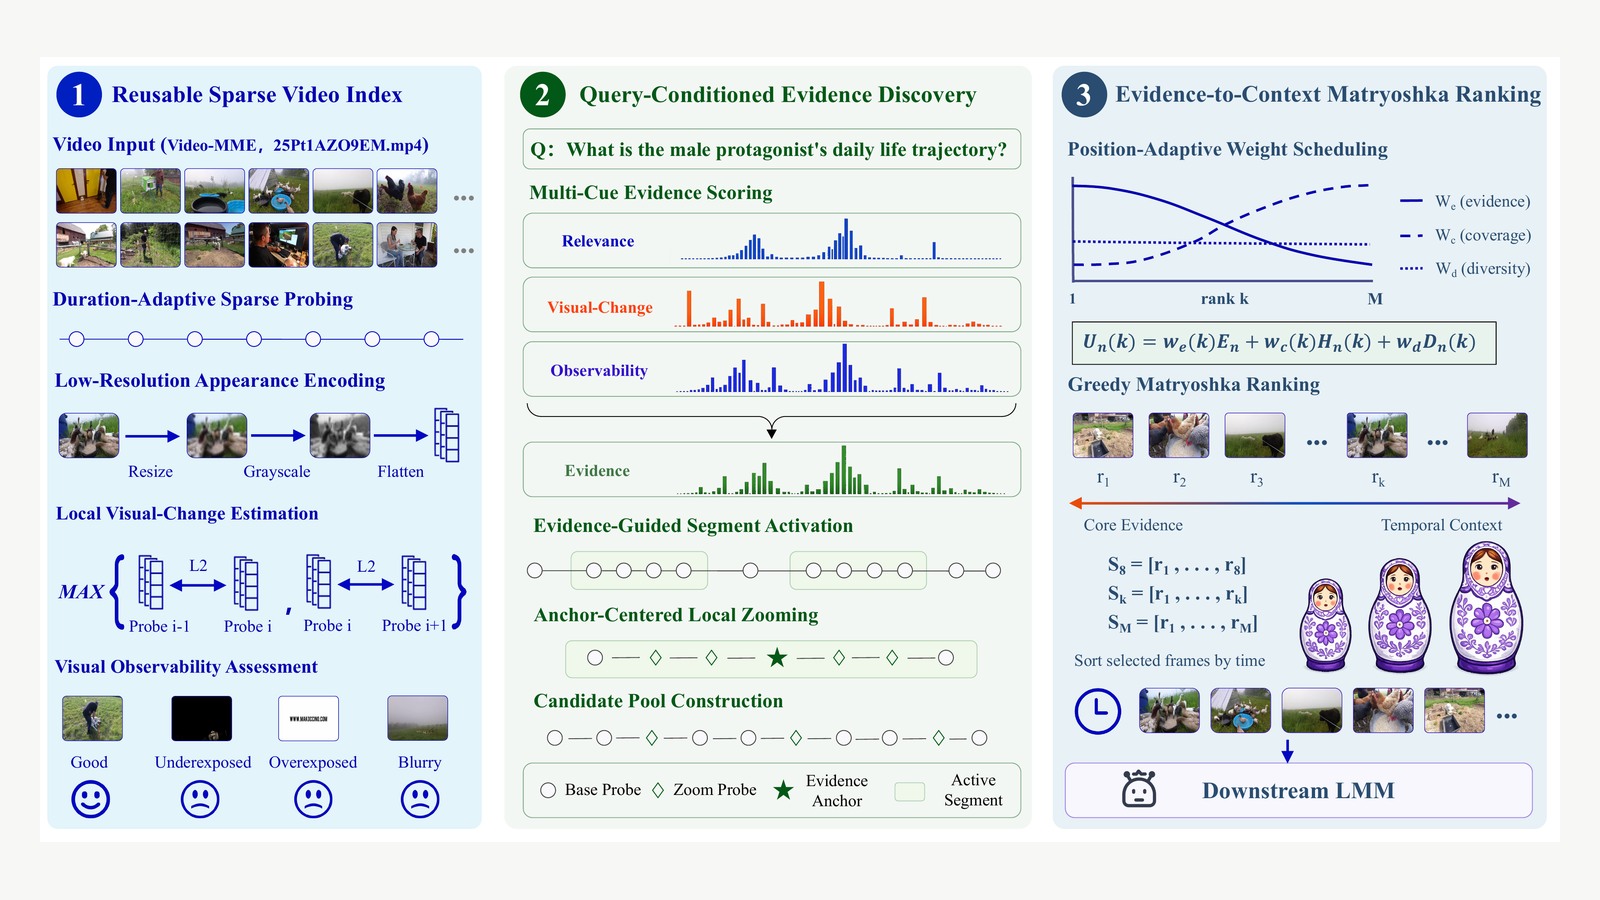
生成一条可被任意预算截断的帧优先序列,使证据从局部线索逐步扩展到时间上下文,并降低重复选帧的延迟。