视频还没有结束时,模型应该怎样理解世界
从流式视频评测、增量推理、长期状态、边看边想一路读到持续视觉智能。难点落在模型怎样随世界变化保存证据、安排计算,并为尚未出现的问题留下余地。
摄像头还在拍,会议还在开,驾驶场景也没有停下来。模型此刻看见的东西,只是一个仍在延伸的世界。几分钟后会问什么,下一秒会不会出现值得提醒的事,它都不知道。
我起初把 streaming video 理解成一件很直观的事,把视频切成小块,来一块就处理一块。论文读得多一些,再顺着公开代码往下追,这个解释很快就撑不住了。切块只规定输入怎样分组。模型能不能看见未来、旧计算有没有复用、什么状态可以跨时间留下、整套系统能否跟上真实播放,各自是不同的问题。它们经常一起出现,于是共用了 Streaming 这个词。
越往下读,我越觉得,“视频切得多细”只是表面,问题的中心落在下面这句话里。
当观察没有已知终点,未来问题也没有提前给出时,模型怎样用有限的内存、每秒计算和响应时间,持续留下足以支持回答、预测与行动的证据。
我把它叫作持续视觉智能。今天的 Streaming Video MLLM 离这个目标还有不短的距离,但已经让其中许多原来缠在一起的问题变得可以测量。
视频在结束之前
视频理解通常从一个文件开始。磁盘上有一段 mp4,时长已经写进容器信息,评测程序知道终点,模型抽取若干帧,随后回答问题。电影理解、课程摘要、手术录像分析和长时监控检索,都可以在这个设定里展开。长上下文、层级检索、视觉 token 压缩和长视频推理也由此发展起来。
这里的计算顺序大致是先拿到完整视频,再处理问题。
即便工程上只抽一部分帧,或者先检索再回答,模型原则上仍能回到整段视频。工程上只能看一部分,通常只是预算有限,那部分世界已经发生。视频更像一份很长的多模态文档,或者一段已经结束、可以反复翻看的记录。
持续到来的观察改变了边界。系统看到的是一串还在增长的输入。
每来一个新片段,它都要把旧状态和新观察合在一起。
问题可能在任意时刻出现,答案只能依赖那一刻已经形成的状态。
系统若还要主动提醒、预测或行动,显式问题甚至不再是每次输出的前提。
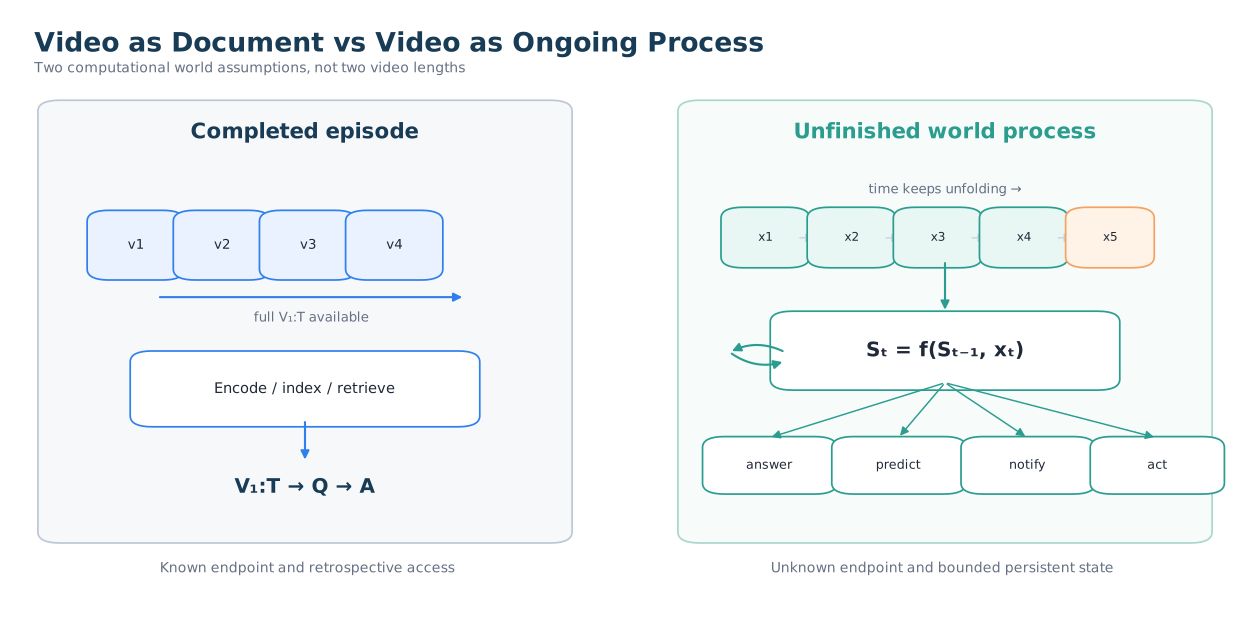
这两类问题的分界不在视频长短。一段十秒钟的安防流也可能要求严格的因果响应,一部三小时电影仍可以在播完以后离线分析。问题属于哪一种世界,要看终点是否已知、未来是否可见,也要看历史计算能否重做,问题何时出现,模型进程又要存活多久。
这个区别也不构成价值排序。离线访问全片,适合跨全片结构分析、精确检索和反复核对,很多医疗、影视、教育与取证任务本来就允许等待。Streaming 研究只是接过另一组约束。它要面对的世界还没演完。
Streaming 的四个层级
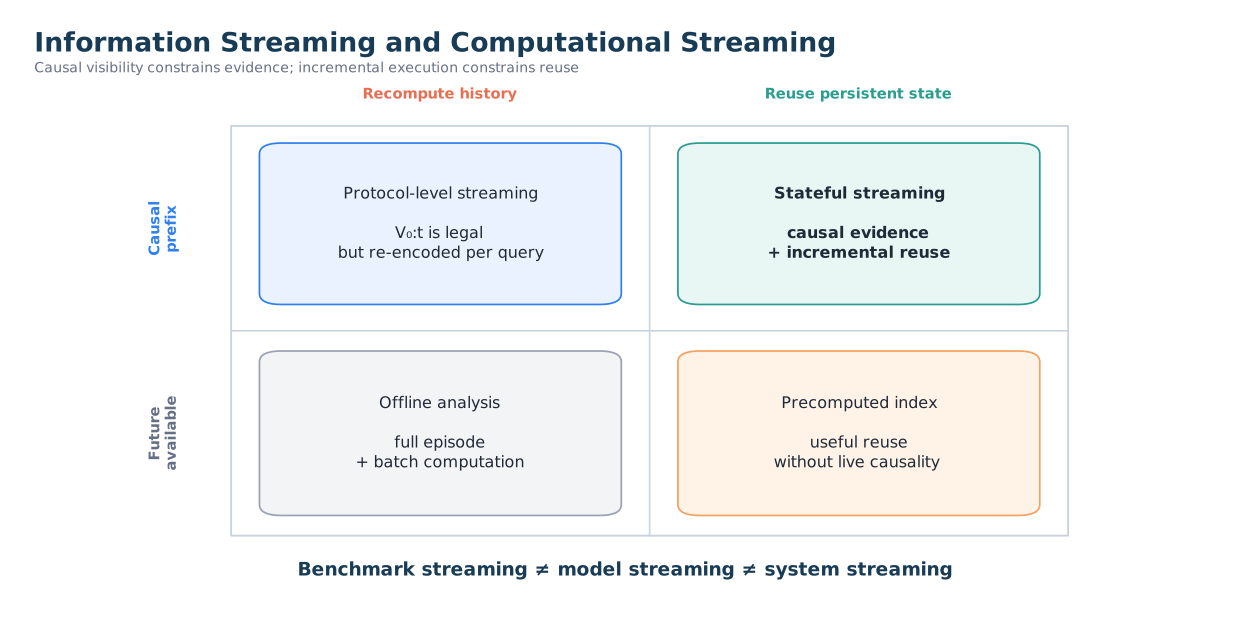
这些论文都使用 Streaming,却约束了不同层级。把它们分成评测协议、推理过程、状态架构和部署系统以后,各自做到了什么,也就清楚了。
第一层是数据和评测协议。问题时间戳有没有给出,未来帧是否裁掉,后续证据怎样逐步释放。OVO-Bench 和 StreamingBench 首先把这一层做成了可复现的任务。
第二层是推理过程。新片段到来以后,模型会重算整个历史,只重算最近窗口,还是只编码新增内容。这一层决定视觉编码、prefill 与 attention 要付出多少重复成本。
第三层落在架构和状态。系统是否跨片段保存 KV、视觉记忆、事件记忆、文本摘要或 latent recurrence。保存下来的东西会不会一直增长,有没有淘汰、合并和纠错。
第四层才是部署系统。进程是否常驻,输入是否按现实时间到达,回答期间能不能继续观察,来不及算时怎样降级,状态跨过几小时甚至几天以后怎么管理。
这四层之间没有自动的递进保证。
一个评测可以非常严格地排除未来帧,同时允许每道题重新编码全部历史。一个模型也可以保留 KV,却从完整文件里高速重放前缀,不知道摄像头下一帧什么时候到。评测层、模型层和系统层彼此相关,谁也不能替另两层作证。
OVO-Bench 管住了哪些时间关系
OVO-Bench 把在线理解分成 Backward Tracing、Real-Time Visual Perception 和 Forward Active Responding。前两类要求模型在提问时刻以前寻找历史或当前证据。Forward 类先给问题,模型继续等待后续线索,再决定什么时候已经足够回答。它把时间关系从过去检索扩展到了响应时机,这一步很要紧。
官方通用评测器的运行方式值得单独说清。Backward 和 Real-Time 读取预先裁好的 id.mp4,Forward 的不同探测时刻读取 id_i.mp4。裁剪脚本意图用从零到 ceil(t) 的片段构造因果前缀,随后每条标注单独调用一次推理。Forward 也是在预定义的若干时刻反复运行,模型没有在同一个会话里自主等待并持续更新。
源码里的边界同样要保留。当前裁剪脚本先跳过非 Forward 任务,后面的 Backward 与 Real-Time 分支因此走不到。官方说明推荐直接下载预裁片段,论文结果很可能使用这些发布文件,但只凭当前脚本无法从原视频完整重建。ceil(t) 还会把小数时间戳向整秒上取整。更稳妥的结论是,截止时刻被离散到秒级;这还不足以证明发布数据已经看见了未来。
论文版本、当前说明和发布标注里的样本统计也不完全一致。规模与平均提问时间只有带上版本才有意义。当前 lmms-eval 集成仍读取这些预裁片段。Forward 虽然使用多轮接口,普通 Qwen2-VL 适配器每一轮依然重新读取完整前缀、运行视觉处理器并调用 model.generate。单次答案解码会使用 cache,视觉状态却没有跨探测时刻保存。多轮评测的名字,无法替模型证明状态真的持续了多轮。
StreamingBench 怎样把流转成离线输入
StreamingBench 覆盖实时视觉理解、多源理解、上下文理解和主动输出。论文直接承认,当时多数模型接不住真正的 stream。除主动输出外,它把每道题裁成从视频开头到问题时刻的片段,再交给普通离线模型。
当前代码后来加入了 context_time。-1 表示完整前缀,60 表示最近六十秒。论文初版以完整前缀为主、最近六十秒为补充,当前说明却把六十秒窗口列为主要协议。脱离版本直接比较分数,很容易把两个不同输入条件算成同一项结果。
Sequential QA 的边界需要单独说明。每次新问题都会重新裁视频并调用模型,文本提示中附带此前的时间戳、问题、选项和标准答案。它测的是带标准交互历史的上下文问答,没有测试模型能否保存自己的视觉状态,也不会让上一轮错误继续影响下一轮。
主动输出使用 polling 模拟响应时机。从标注起点开始,模型每秒处理一个增长的局部片段,并被明确询问现在是否该输出。接近标准时刻才算正确。它确实比固定时间问答更接近持续环境,也仍然知道应该在哪段时间附近检查,而且每次轮询都会重新推理。这里测到的是带时间锚点的响应判断,距离自由运行中的主动通知还有一步。
我不愿意因为这些限制低估两套评测。它们把因果问答、误导历史、向前等待、多模态交互和响应时机变成了共同任务,也为后续状态架构提供了共同的评测基准。它们没有声称统一限制每秒 FLOPs、跨问题复用 KV 或维护常驻服务,我们也不该用这些额外目标反过来否定它们。
看见过去以后,旧计算要不要重做
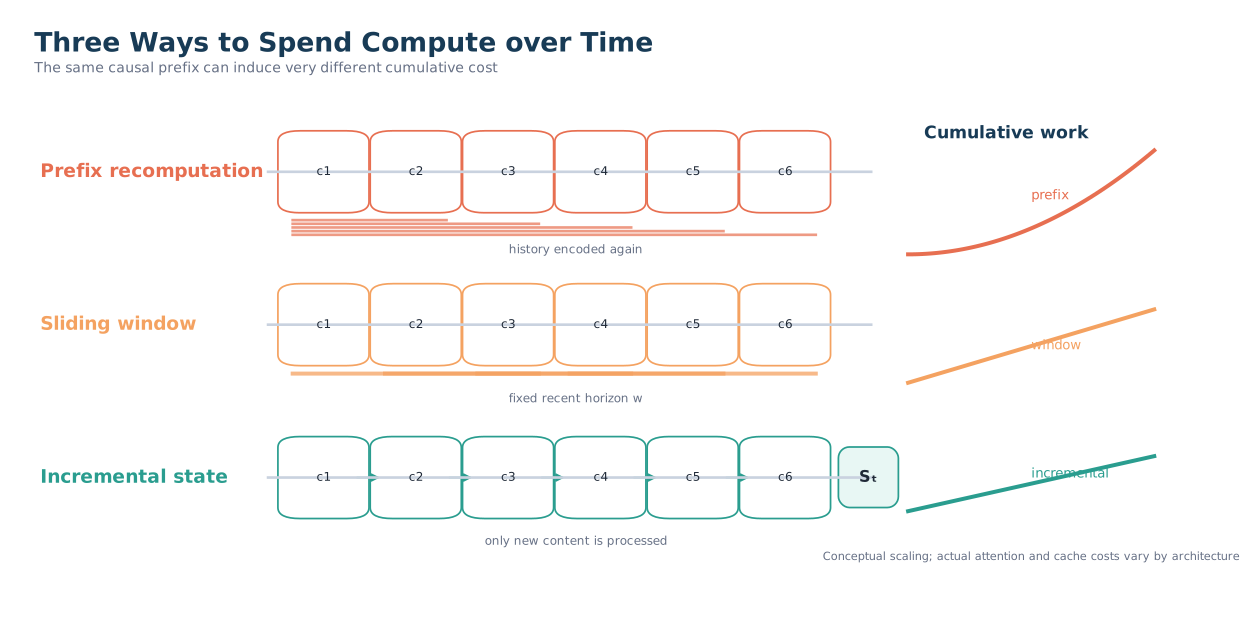
一个模型可以只看 V_0…t,信息上完全合规,同时在每次提问时把整个前缀重新送进视觉塔和语言模型。未来没有泄漏,旧工作却一遍遍重做。
假设问题出现在 t₁, t₂, …, tₙ,完整前缀重算的总处理量近似为
探测频率若固定,问题数量会随视频变长,重复处理量可能呈二次级增长。固定帧数采样会把更长前缀稀释得越来越疏,固定帧率又会让视觉 token 一直增加。两者的准确率、FLOPs 和遗忘方式差得很远,却可能共享一个因果评测分数。
计算流式关心的是,新内容到来以后,旧历史还要重做多少。常见路线大致如下。
| 推理方式 | 新时刻送入什么 | 旧计算怎样处理 | 状态是否增长 | 主要代价 |
|---|---|---|---|---|
| 完整前缀重算 | 从开始到当前的全部视频 | 不复用 | 输入持续增长 | 重复视觉编码与 prefill |
| 滑动窗口重算 | 最近固定窗口 | 不复用 | 有界 | 窗口外证据直接消失 |
| 分块更新 | 新片段 | 部分复用 | 取决于记忆 | 跨片段状态需要单独定义 |
| 持久 KV | 新 token 或新片段 | 高度复用 | 需要淘汰策略 | 位置、淘汰和 cache 语义会互相影响 |
| 外部记忆 | 新片段和检索出的状态 | 视觉计算可增量 | 可以有界,也可以持续增长 | 写入、检索和压缩都会引入误差 |
| 周期或事件触发 | 被选中的时刻 | 自适应 | 可控 | gate 可能漏掉罕见关键事件 |
滑动窗口常被低估。它没有跨问题复用视觉编码,算不上最强意义的增量推理,却给出了清楚的计算边界。每次只处理最近 w 帧或 w 秒,输入规模不会随总时长膨胀。这个差别,比给它和完整前缀都贴上 causal evaluation 的标签更有工程意义。
一条很朴素、也很难绕开的基线
SimpleStream 故意把策略压到最简单。问题出现时只取最近 N 帧,以每秒一帧送进现成 VLM,窗口外全部丢掉。论文报告四帧版本在 OVO-Bench 上达到 67.7% 平均准确率,在 StreamingBench 上达到 80.59%。继续增大窗口没有稳定收益,最合适的 N 会随主干和任务变化。
我觉得这项结果最有用的地方,在于反过来照出评测由什么组成。它还不足以判断记忆是否有价值。若大多数问题只依赖眼前几秒,强视觉主干配上干净的近期证据,本来就该占优。更长历史可能帮助 EPM、ASI 等记忆任务,也会把无关画面带进当前感知。论文自己的 Visual-RAG 实验就在一些记忆轨道上变好,同时损伤幻觉检测和即时感知。StreamForest 的复分析也出现了记忆收益与感知损失并存。
最近四帧很强,至少容得下几种解释。评测里的远距离依赖比例不高,历史证据存在却非常稀疏,或者复杂记忆带来的压缩与检索错误抵消了信息增益。要把这些解释分开,需要报告证据距离、任务分层,并把计算预算配平。否则“窗口基线赢了”只告诉我们结果,还没告诉我们原因。
StreamOPD 又给了一个训练侧对照。它把推理固定在每秒一帧、最近四帧,不加记忆、检索或在线思考模块,只研究后训练和教师蒸馏。论文报告 OPD 让 StreamingBench 从 77.87 提到 83.91,ST-CueGate 又到 84.55。部分标成 backward 的 OVO 轨道也随训练提高,尽管被窗口逐出的历史从未进入模型。这说明某些记忆标签还混着局部线索、模型先验和输出策略。StreamOPD 证明的是训练方法有效,不能把这份收益记到长期状态架构上。
Persistent KV 到底复用了哪些计算
StreamingVLM 是一条较清楚的计算流式路线。官方推理在每秒新片段之间保留各层 past_key_values,旧视频不再反复穿过视觉塔。状态大致由早期文本、近期文本和最近十六秒视觉组成。视觉内容超出窗口以后,其 K/V 会被物理删除,部分旧文本也会淘汰。每个新片段只做一次视觉编码和新 token 投影。
“历史零重算”仍然说得太满。Qwen2.5-VL 使用 3D mRoPE,cache 淘汰以后,官方 shrink 模式会为整个活跃 cache 重建连续位置,对保留下来的 key 重新施加旋转变换,再完成当前 attention。旧视觉塔、旧 MLP 和旧 Q/K/V 投影得到了复用,活跃窗口上的位置修复与 attention 仍然要算。
论文图中的 512 个 sink text、512 个 recent text 和十六秒视觉是一种策略概括。实际 cache 还装着最近几轮的角色分隔符、时间戳、模型 commentary 和当前请求。更早的视觉 K/V 会消失,远期信息能否留下,很依赖模型当时有没有在 commentary 里说出那件事,以及这段文字后来是否又被淘汰。它已经证明持续计算和主要 KV 可以受控,却没有顺带获得与未来问题无关的长期视觉记忆。
论文报告单张 H100 最高 8 FPS,单 token 延迟约 0.05 秒,并在平均 2.12 小时的 Inf-Streams-Eval 上评估。补充 demo 是连续运行一百分钟后的剪辑片段,不能写成一段未经剪辑的两小时演示。训练使用 Qwen2.5-VL-7B,计算量约为 128 H100-days。这些数字说明系统代价,也提醒我们把 demo、评测与持续部署分开看。
StreamingLLM 留下的是一套计算原则
原始 StreamingLLM 面向持续文本生成。它保留少量开头的 attention sink 和最近 K/V,丢弃中间历史,再用相对 cache 的位置保持解码稳定。论文展示了超过四百万 token 的持续生成,并报告相对滑动窗口重算最高 22.2 倍加速。
官方说明也很坦白。它没有扩大语义上下文,更没有增强长期记忆。远处的 passkey 离开 cache 以后就找不回来。它给视频系统留下的是持久 KV、选择性淘汰和位置修复这三条计算原则。视觉流还要额外处理视觉编码成本、视觉与文本的不对称淘汰、3D 位置,以及模型输出重新写回状态以后会发生什么。
ViCoStream 把问题推进到流水调度
ViCoStream 把每个片段拆成视觉预处理、ViT 编码、token 丢弃和 LLM prefill 四个阶段。若不同片段能在四阶段重叠运行,稳定吞吐由最慢阶段决定。
论文里的单张 A100 最高 134 FPS 来自这条理想流水公式。保留 30% token、每个片段十六帧时,四阶段耗时约为 113、119、44 和 42 毫秒,最慢的 ViT 给出约 134 FPS。若四步顺序相加,端到端吞吐会是另一个数。
公开代码能确认分块持久 KV、token dropping、近期片段 attention 和提问侧检索。当前可见路径仍是顺序 Python loop,没有发布四阶段 CUDA stream 调度器。代码先把新 K/V 追加进 DynamicCache,再把当前 attention 切到近期 K/V,我没有看到旧 KV 被删除。于是 attention 可以保持在固定范围,存储的 cache 仍可能一直长。attention 有界,并不代表总计算和存储也都受控。
系统带到下一秒的是 State
读到这里,memory、cache、compression 和 thinking 已经很难再被当作几块互不相干的零件。新画面不断进来,系统总得决定过去以什么形式留下。几条技术路线最后都汇到同一个状态更新问题上。
只要视频可能一直继续,这个状态还得守住容量上限。
留下最近的原始帧,细节最完整,覆盖时间却很短。把画面存成 visual embeddings 或 tokens,可以省去重复解码,状态仍可能随时间线性增长。KV cache 能复用 Transformer 已经做过的计算,它保留什么语义,取决于训练方式和 eviction policy。Event memory 把时间组织成事件,容易漏掉背景里的细节。Text summary 很紧凑,也方便检索,颜色、位置以及没有被语言说出来的东西会随压缩一起消失。Latent state 容量灵活,出了错却不容易查。Hybrid state 把几种载体分层放在一起,更新和检索随之变得更复杂,一致性也要单独维护。
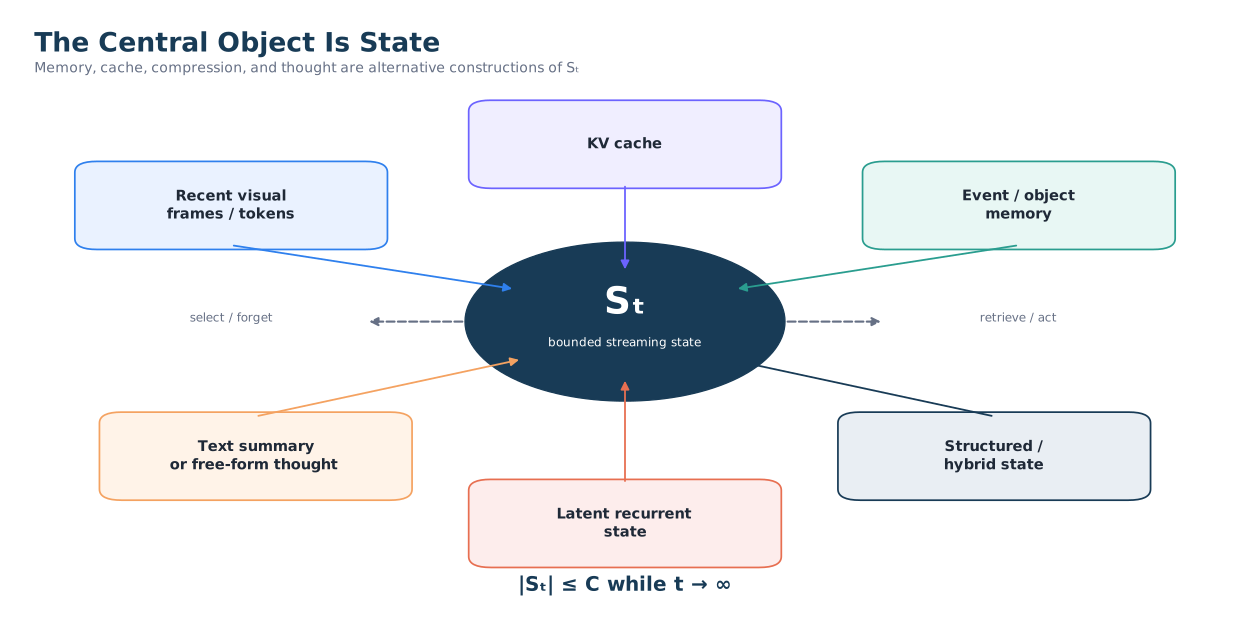
Sufficient statistics 提供了一种好用的解释框架。理想的 St 要留下未来任务会用到的信息,把无关冗余舍掉。困难在于 query 尚未出现,任务分布也可能改变,开放世界里很难得到严格的统计充分性。更现实的目标,是让状态对一组任务保持足够信息,再用未知 query 检查它的鲁棒性。
Information bottleneck 也能帮助理解 state compression,前提是别把解释框架写成论文已经优化过的目标。当前多数工作没有显式训练经典 information bottleneck objective。这个概念在这里说明的是压缩率与未来信息损失之间的取舍。压得越狠,状态越容易保持有界,未来问题所需的细节也越可能被提前删掉。
把这些方法放回 state update 以后,几个经常混在一起的词就能各归其位。
| 概念 | 它解决的主要问题 | 它不会自动带来的能力 |
|---|---|---|
| Cache | 复用已有 projection 和 decoding state | 保留远期语义 |
| Memory | 保存历史证据,或在需要时找回证据 | 增量计算和实时吞吐 |
| Compression | 控制 token 数量与状态规模 | 保证未来 query 仍能回答 |
| Thinking | 对当前 state 做额外 transformation | 证明系统具备推理能力 |
| Retrieval | 从历史里选择证据 | 保证历史最初已经被正确写入 |
| Forgetting | 释放预算,移除 stale state | 判断该在什么时候忘记什么 |
Persistent KV 可以存在很久,长期记忆仍然可能很弱。Event memory 也可能每遇到一个 query 就重算整段视觉 prefix。具体模块告诉我们系统用了什么,state construction 和 state update 才能说明它究竟把什么带到了下一秒。
长期运行会把差异逼到台前
短 clip 容得下许多含糊设计。模型容量够大时,多存一点、多算一遍,结果未必立刻难看。时间一旦继续拉长,状态、计算和响应延迟都要面对明确上限。
这里的 M(t) 是 working state,C(t) / t 表示单位视频时间需要付出的计算,Lt 是响应延迟。三道上界会把取舍一项项逼出来。Token compression 也许压住了显存,每秒计算仍可能超标。KV reuse 可以让系统跟上实时输入,cache 却可能一直长。Recent window 最容易同时控制内存和计算,代价是远期证据离开窗口后便无从找回。
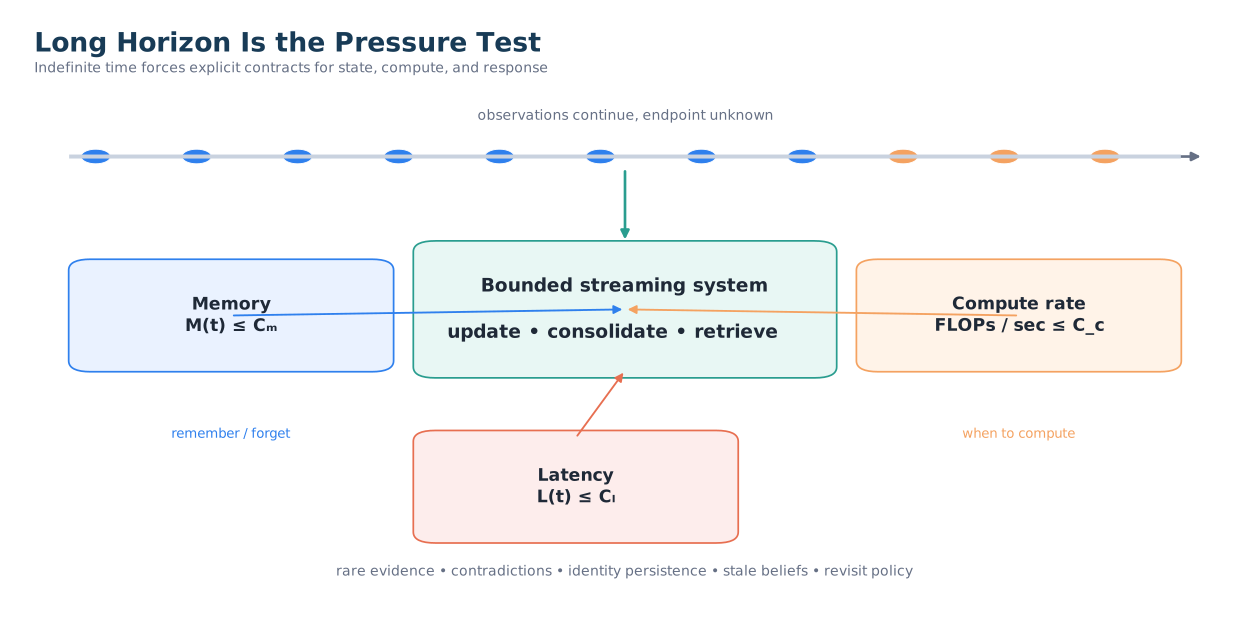
一个小时前出现的物体可能换了身份,后来的观察会推翻早期判断,同一批参与者也会改变外观、位置和称呼。Object persistence 要跟住对象,belief revision 要容纳修正,矛盾和 stale memory 还得被发现。多存一些 token 只能把这些问题往后推。
StreamForest、ObjectStream、StreamFlow 和 LiveStarPro 都可以放进这个状态问题里读。StreamForest 用 Persistent Event Memory Forest 把帧组织成事件树,合并时参考时间距离、内容相似度和合并频率,同时保留近期的细粒度窗口。ObjectStream 让无需检测器的潜在对象充当记忆锚点,持续记录对象历史,再把临时变化和近期上下文放在周围。
StreamFlow 在昂贵视觉编码之前,用感知动态的中期过滤器去掉重复内容,历史随后被整合成可按需注入的视觉潜变量。LiveStarPro 则把主动响应时机、因果注意力训练与树状层级记忆装进同一套系统。
它们选择了不同的压缩单位。Frame-level state 更照顾细节,event-level state 更容易保存时间结构。Object-level state 擅长维持身份连续性,latent memory 则把容量交给端到端训练。未来问题可能正好追问某种表示最容易删掉的信息,因而没有哪一种载体天然占优。
SimpleStream 的结果很适合拿来做一次压力诊断。最近四帧如果已经很强,先看评测里的证据依赖距离分布,确认长期证据到底隔了多远、出现得有多稀。随后固定主干、视觉 token、更新 FLOPs 和提问阶段计算,再看记忆方法还能增加多少。完成这些检查以后,记忆形式的优劣才有可比基础。强近期窗口能暴露评测和预算问题,直接用它判定长期记忆没有价值,会漏掉中间整条因果链。
一边看,一边把思考写进状态
Streaming Thinking 常被理解为模型边看视频边生成思维链。比较不同系统时,更有用的是检查新片段触发了什么状态更新,计算发生在什么时候,结果又以什么形式留下。
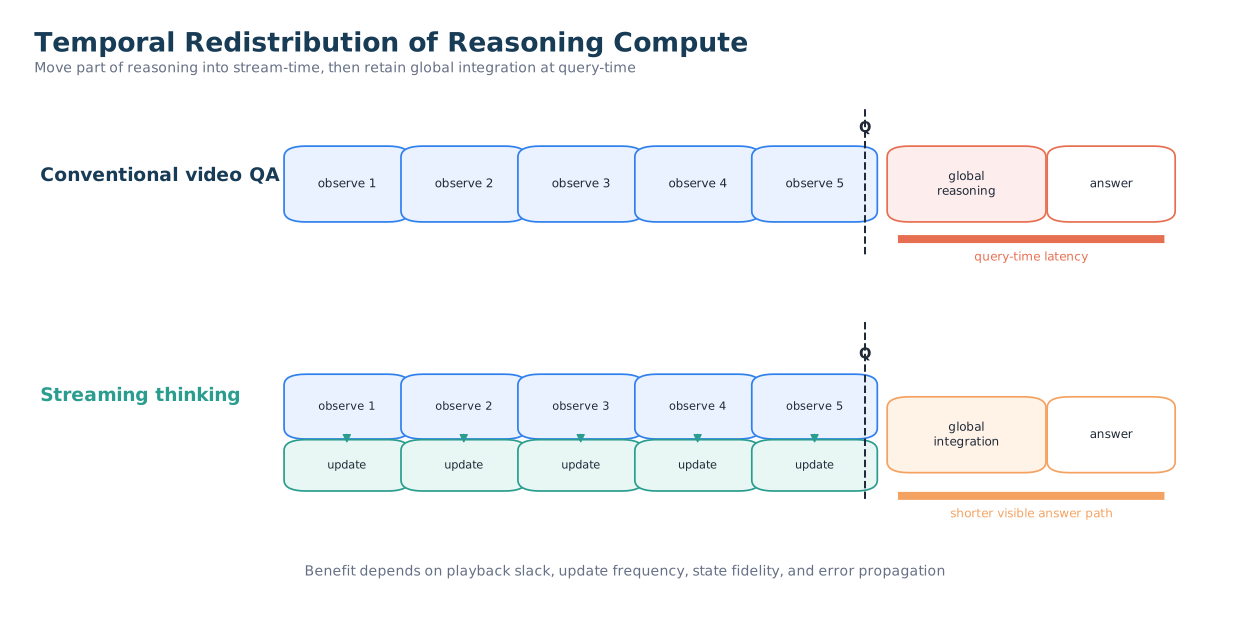
传统 Video QA 通常把推理集中到 query 出现以后。
Streaming Thinking 把其中一部分工作挪到视频播放期间。
Query 到来以后,系统再做一次跨片段整合。
这相当于重新安排推理计算在时间上的位置。传统系统等视频和问题都到齐,再一次付出集中的思考延迟。Streaming system 利用原本就在流逝的播放时间,提前解释当前观察,做局部推断,或压缩记忆。问题出现时,最后那段响应就可能短一些。计算没有凭空消失,它只是被挪到了更早的时刻。
VST 把视觉逐段改写为文本记忆
Video Streaming Thinking 的抽象很清楚。当前 clip ck 与上一轮文本记忆 mk−1 一起生成 thought zk,随后用这次 thought 更新记忆。
回答阶段读取累积文本、最新 visual clip 和 query。论文把它们分别理解为 short-term native video memory 与 long-term textual semantic memory。视觉内容逐段进入,旧内容被改写成文本,再带到下一段,这是一种 visual-to-text recurrent state construction。
官方 OVO evaluator 把这套抽象落成了一条很具体的流程。完整 causal prefix 先按 2 fps 采样,最多保留 384 帧。超过上限以后,采样器会在整个 prefix 上均匀抽稀。程序再按 prefix 总时长把视频分成两到五段,前 N−1 段逐段生成 thought,最多四次,最后一段与 query 一起进入回答。每轮只送入当前 visual chunk,过去由前几轮生成的文本重新拼回 prompt。不同轮次没有显式传递 past_key_values,累积 textual memory 每轮都会重新 prefill。
旧视觉已经变成较便宜的文本状态,因此这条路径比每轮重算全部历史视觉更接近 computational streaming。Session 仍然不会跨 query 保存。同一源视频换到另一个 timestamp,evaluator 会重新初始化 textual memory。它也会先拿到完整 prefix 文件,完成全局采样和等分,然后才开始逐段推理,真实输入的 arrival pacing 没有进入这套流程。
论文提出 FIFO 来限制长期 memory,官方 OVO benchmark 脚本里的 max_keep_memory 默认值却是 0。评测最多只产生四次 intermediate thought,状态在这段范围里不会爆炸,但 indefinite stream 上的 FIFO 行为并没有被实际检验。VST 在 StreamingBench 的论文主结果还使用了专用 single-pass evaluator。它保留最近采样帧,只调用一次 generate,没有执行 intermediate thought loop。报告中的 79.5 能说明 VST-trained checkpoint 在该协议下表现很强,单靠这个数字还不能把增益归给 streaming thought。
论文报告 background thought 每 16 到 32 秒异步触发一次,平均用时 7.0 秒,P99 为 11.2 秒。Query 打断时,系统使用最近已经完成的 memory state。一个 case study 中,最终 QA latency 为 0.51 秒,对照 post-query CoT 为 9.53 秒。公开 benchmark evaluator 没有 wall-clock scheduler,也没有 interruption handler。这组时延数字来自论文报告,发布的评测脚本目前不能独立复现。
论文列出的失败方式更能说明文本状态付出的代价。显著却无关的事件会占据记忆,过度压缩可能丢掉关键 span。局部 thought 也可能漏掉跨事件关系,一次错误随后会被下一轮当成事实继续使用。Textual thought 在这里同时充当 reasoning trace 和有损 semantic memory,两件工作绑在一起,错误也会沿同一条链往后走。
ThinkStream 让 thought 留在 KV 里
Thinking in Streaming Video 提出的 ThinkStream 使用 Watch, Think, Speak loop。每个新 chunk 触发一次短 reasoning update,模型随后决定 silence 还是 response。Reasoning-Compressed Streaming Memory 保留最近的 visual K/V,过期 dense visual tokens 会被逐出,历史 reasoning 和 response token 的 K/V 则继续充当 semantic anchors。
VST 把 thought 放在外部 prompt memory 里,ThinkStream 进一步把它写进 model cache state。论文的典型设置保留 20 秒 dense visual window,每秒最多允许 20 个 reasoning tokens。Token budget 从 0 增至 20 时,OVO-Backward 从 41.8 提升到 52.3,单步 latency 也从 130 ms 增至 380 ms。Budget 继续加到 30 tokens,分数只到 52.6,latency 已升至 505 ms。这组 ablation 把 thinking frequency 和 token budget 的代价摆得很直白,它们都是 compute allocation policy 的一部分。
论文也比较了几种 memory representation。No-memory average 为 56.9,discrete caption memory 降至 48.7,cold-start CoT memory 为 60.5,RLVR-optimized CoT memory 达到 64.8。结果支持训练过的 reasoning state 优于论文所实现的朴素 caption。它还不足以推出 reasoning 普遍优于 summary,因为 caption 与 CoT 的生成目标、token 数和训练方式没有完全匹配。更严格的实验需要固定 backbone、总 token、visual evidence 和 update FLOPs,再比较两种状态表示。
ThinkStream 把 visual window 控制在固定范围,reasoning tokens 仍以较慢速度积累。它缓解了 dense visual KV 的增长,自定义 CUDA Graph engine 还报告了小于 0.5 秒的 2 FPS processing threshold。公开引擎确实为每层预先分配 static KV,新 chunk 到来时只 prefill 新输入,visual span 超过窗口后会 compact cache。默认 max_len=24576,每秒 20 个 reasoning tokens,粗略换算约为 20.5 分钟的上限量级。实际时长还受提前结束和其他 token 影响。若系统要让状态大小严格不随时间增长,reasoning state 仍需要长期 consolidation 或 eviction 上界。
TaYS 与 StreamingThinker 把计算放进输入过程
Think-as-You-See 把 StreamingThinker 的文本方法迁移到视频。Streaming attention mask 保证每个 reasoning step 看不到后续视觉,decoupled position encoding 处理视觉输入和 reasoning output 的位置冲突。Parallel dual KV cache 则让 frame ingestion 与 token decoding 可以并行。论文在 VideoEspresso 上报告 accuracy 提升 2.9 个点,TTFT 从 10.6 秒降到接近零,reasoning-event deviation 从 1.52 秒降至 0.69 秒。
这里的 near-zero TTFT 有明确计时口径。Reasoning 在视频仍然到达时就已经开始,若从完整 input receipt 起算,等待自然会接近零。这能证明计算重叠降低了 answer-ready latency,却不表示 thought 没有成本。Stream-time compute 一旦超过播放间隔,积压还是会出现。
公开实现给出的证据边界比论文架构更窄。一条主要评测路径会先编码完整视频,再对不断增长的 causal prefix 多次调用 generate,轮次之间没有传递旧 past_key_values。另一条 LiveCC path 维护单个持续 KV,却没有可审计的双 worker 并发 scheduler。Dual-cache、zero-copy merge 和 asynchronous overlap 目前属于论文的 architecture claim。当前 release 能直接支持的是 causal generation 与更好的 temporal alignment。
StreamingThinker 原本研究纯文本的 thinking while reading。它把 source input 和 reasoning stream 分开定位,分别维护 source KV 与 reasoning KV,再用 causal mask 限制每个 reasoning unit 只能依赖已经读到的句子。D1 就地做局部推断,D2 在读完后完成 global integration,D3 随后反思。实验中,D2 带来的 accuracy recovery 最大。论文还报告 token waiting 减少 80%,final-answer time-level latency 降低超过 60%。这套时间模型把阅读速度设为每分钟 150 words。
这项文本工作提供了一条可以迁移到视频的结构判断。Local thinking 适合在证据刚出现时就近消化,跨片段关系仍要交给 global thinking。把 batch CoT 机械切成许多小段,会损伤全局一致性。
发布代码也留下了清楚边界。论文描述 source encoding 与 reasoning generation 同时进行,当前 generate.py 主要在一个 Python while loop 中交替推进,并通过 torch.cat 合并 cache,独立并发 scheduler 尚未公开。D1 到 D2 的 accuracy 变化属于可见的算法证据,并发速度仍应按论文系统主张来引用。
ThinkOmni 与 WAT 划出两条边界
ThinkOmni 在 decoding 阶段用 off-the-shelf Large Reasoning Model 指导 omni-modal model,并通过 Stepwise Contrastive Scaling 平衡感知与推理分布。它是一种 training-free query-time reasoning enhancement,不会随视频推进持续维护 state。这一参照说明 multimodal reasoning 和 streaming reasoning 可以分别增强。方法即便明显提高了 reasoning,也可能继续使用完整输入后的 batch decoding。
WAT 采用 Watching Before Thinking。Query-independent watching stage 同时维护 high-fidelity short-term memory 和固定容量 long-term memory,后者强调语义多样性。论文配置保留 16 个 STM frames、768 个 LTM entries,query 到来后检索 top 32,再开始 reasoning。它没有持续生成显式 thought,continuous state construction 仍然成立。因此,Thinking 不宜只按 textual CoT 识别。核验材料中尚未找到可审计的官方仓库,这里只采用论文给出的方法和结果。
边看边想也是状态更新
把这些方法并排放好以后,thinking 的范围会清楚许多。每一个 streaming step 都可以写成一次受计算预算控制的状态更新。
ct 表示当前 step 获得的额外计算。Text thought 是 St 的一种外显形态,structured event update 和 object track update 也会改变状态。Latent recurrence、KV rearrangement 与 memory consolidation 没有可读的自然语言,同样可能承担比较、归因、更新或预测。
这样的定义让 thinking 重新变得可检验。Thought 如果只是把视觉内容缩成一段短文本,主要收益来自 semantic compression。若它能在 matched summary 无法解决的任务上稳定增加结果,并且留下可核对的中间推断,才有更充分的理由把收益归为 reasoning capacity。
文本状态能直接接进 LLM 现有接口,便于检索和审计,表达同样语义时也通常比视觉 patch 少用很多 token。代价同样具体。没有被语言命名的视觉细节很难恢复,生成错误会跨时间积累。自由文本又缺少可验证的结构,观察、假设和当前信念很容易写进同一句话,后来再想拆开就麻烦了。
一种更稳健的做法,是给状态里的内容分配类型与置信度。Observation 记录某个时刻实际看到了什么。Hypothesis 保留尚未验证的推测,entity state 表示当前仍有效的属性,episodic link 指回可以重新读取的视觉位置。后续证据若产生矛盾,系统可以更新 current belief,同时保留过去发生过的 episode。自然语言仍可当作人和系统交互的界面,内部状态无需全部压进一段找不到来路的 free-form thought。
计算是按时间花出去的预算
Streaming Thinking 的收益来自计算时间被重新安排,代价也从这里产生。观察期间的总成本可以拆成视觉编码、状态更新与记忆整合。
Query 到来以后还有 Cquery。只看最终 TTFT,会让那些把大量工作提前完成的系统占便宜。只看总 FLOPs,又会把低 response latency 对在线系统的意义抹平。评测需要同时留下这两笔成本,还要记录 real-time factor、backlog 和 deadline miss rate。
许多实现默认每个 chunk 都值得 thinking。固定每 16 秒触发一次、每秒生成 20 tokens,或者每帧调用 action head,这些 schedule 容易训练,也方便 batching。视频若长时间静止、内容反复出现,固定更新会把预算花在低价值片段上。调度器至少要判断当前观察有没有带来新信息,也要知道状态里是否出现需要修正的不确定性。至于这次更新跳过去会损失什么,应当进入同一项预算决策。
Asynchronous thinking 还会碰到版本一致性。Query 到来时,后台 update 可能刚算到一半。系统可以等待最新结果,也可以直接使用最近已经完成的状态,还可以中断这次更新并回滚。VST 选择最近完成的 memory。更一般的实现需要给 state 编号,记录每个 answer 对应的 observation cutoff 和 memory revision。这样回头检查遗漏时,才能区分信息还没到、更新尚未完成与检索没有找到证据。
Thinking frequency 最终适合成为 learned control variable。Gate 的选择也可以比 compute 或 skip 更细。轻量 caption、structured update、昂贵 global consolidation 和 external retrieval 都消耗不同预算。系统根据当前状态选其中一种,temporal compute allocation 才会从固定 schedule 变成受预算约束的决策。
Codec 先帮系统决定看哪里
视频 codec 早已在处理一个相邻问题。相邻帧大多重复,没有必要把每个像素都当成新信息重新编码。I-frame 或 anchor 保存较完整的外观,预测帧用 motion、residual 和 bit cost 描述变化。VLM 首先可以把这些信号用作 evidence allocation,提前决定哪些时刻、哪些空间区域值得生成视觉 token。
OneVision-Encoder 在论文方法中用 codec-aligned sparsity 选择 patch。送入 ViT 的内容仍是解码后的 RGB patch,motion vector 与 prediction residual 负责决定位置。稀疏 patches 随后被打包进 canvas,原始的 (t, h, w) 坐标另行保留,交给 3D RoPE。LLM 并没有直接读取压缩系数。
公开实现把视觉编码、时空位置和视频读取拆进不同模块。与论文一起发布的预处理主路径使用 bitcost 和 readiness,论文方法写的却是 motion vector 与 residual。两套信号都服务于稀疏选择,证据层级并不相同,引用结果时需要分开说明。
codec-video-prep 把这条流程做成了可复用的预处理包。它从 H.264、HEVC 或 VP9 提取块级 bitcost,建立自适应 readiness 分组,再从全局选出一批 2×2 图像块。选中的 RGB patch 被打包成 canvas,原始位置另外保存。代码中仍留着 motion vector 加 residual 的旧路径,当前主路径默认使用 bitcost 和 readiness。论文公式、旧实现与公开主路径指向不同层,合在一句里会把实现说错。
LLaVA-OneVision-2 把图像、采样视频和 codec-stream canvas 接进统一的视觉 token 接口。论文描述了随 bitcost 变化的逻辑 GOP、motion-residual 空间分数、2×2 图像块选择与组内可见注意力。Codec-stream 训练只用于后期课程中的部分长视频数据,最高使用 384 和 768 个源帧,其余训练输入没有全部改走 codec 路径。发布时的运行流程还依赖处理器、checkpoint remote code 和早期预处理包,单看一个入口函数无法还原论文的全部评测设置。
Mage-VL 的 Mage-ViT 使用 16×16 patchifier。传统 HEVC 分数结合运动向量幅度与 P 帧残差能量,DCVC-RT 路径使用负对数似然。输入为 64 帧、256×256 时,稠密输入共有 16,384 个 patches。预算设为 4,096,相当于减少约 75% token。第五阶段冻结视觉主干和基础 LLM,再用约 335 万条流式样本训练 silence/speak gate。
Mage-VL 的公开 demo 也显示出论文方法与可运行系统之间的距离。传统 codec 路径实际委托给 codec-video-prep 的 bitcost/readiness,ViT 读取的依然是筛选过的 RGB patches。程序会先切分并预处理完整视频,一次 gate 调用评估全部片段,生成时只使用当前片段。论文图 3 所示的持久实时接口和最近 N 段生成路径,还没有在公开 demo 中出现。
这些工作可以确认 codec metadata 已经能在给定 token budget 下安排空间与时间证据。让同一组信号进一步决定什么时候调用昂贵计算,目前仍是本文提出的研究假设。
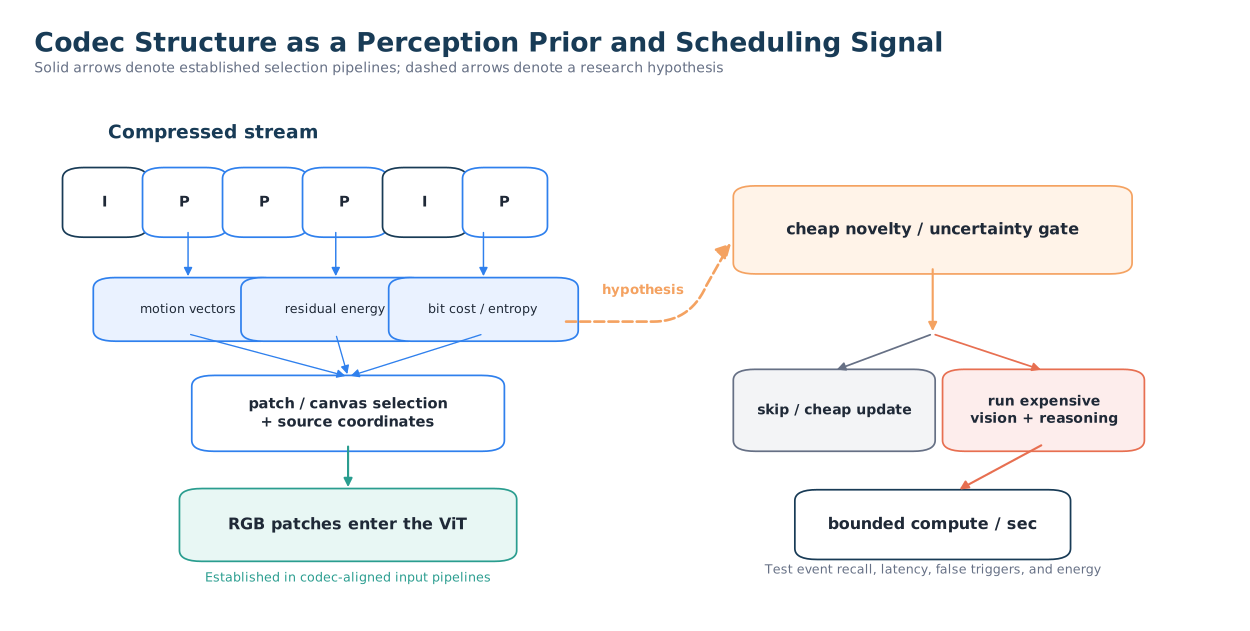
一个控制器可以读取关键帧、运动幅度、残差能量、码率、GOP 边界和场景切换。重复片段只做轻量状态更新,残差升高或出现新对象时再调用完整视觉塔,语义不确定性继续升高时才触发推理。Codec 信号计算便宜,也会随视频自然到达,很适合放在调度的前端。
反例也很具体。静止画面里的小字、状态灯颜色,或者缓慢累积的危险,bit cost 可能很低,未来问题却可能正要追问这些细节。剧烈相机运动会制造巨大残差,语义上未必出现新东西。Codec gate 只适合充当低成本候选,语义判断还要结合场景含义、不确定性和罕见事件保护机制。
今天的系统走到了哪里
这些工作沿着不同方向前进。OVO-Bench 和 StreamingBench 约束未来可见性、问题时间与回答时机,SimpleStream 用近期窗口给复杂记忆方法设下一条很强的基线。StreamForest、ObjectStream 和 WAT 研究事件、对象与分层视觉记忆,VST 和 ThinkStream 把观察期间的推理写进状态,StreamingVLM、MOSS-VL 与 ViCoStream 则把增量计算和吞吐往前推。
它们无法排成从低到高的一条线。公开评测与长期持续运行之间仍有距离,眼下更适合按各自已经做到的部分,以及保留的离线条件逐项对照。
| 工作或协议 | 已经做到的部分 | 仍然保留的离线或有限期条件 |
|---|---|---|
| OVO-Bench 主评测 | causal prefix 与 forward probes | 使用预裁视频,每个 probe 独立推理 |
| StreamingBench 主评测 | 按时间戳裁剪,并用 polling 测主动输出 | 已知检查时间邻域,每次 query 或 poll 都会重算 |
| VST 的 OVO 路径 | 在单个样本内递归地把视觉写成文本状态 | 先拿到完整 prefix 再采样,跨 query 重建状态 |
| SimpleStream | 输入始终限制在最近窗口 | query 到来后重算窗口,没有常驻状态 |
| StreamForest 与 ObjectStream | 方法里都有有界增量记忆 | 官方评测仍会在每个 prefix 内重新建立记忆 |
| StreamingVLM | persistent KV,并会淘汰旧状态 | 输入来自视频文件,远期视觉主要依靠 commentary 保留 |
| ThinkStream | persistent KV 与 visual-span eviction | 完整文件预先载入,reasoning KV 受固定最大长度约束 |
| LiveStarPro 公开版本 | 主动输出与层级 caption tree | streaming loop 开始前先编码整段视频 |
| Mage-VL demo | codec token selection 与 speak gate | 先切分完整视频,尚未提供常驻 live state 接口 |
| MOSS-VL | frame arrival session 可与生成并行 | visual cache 只追加,默认运行受最大帧数限制 |
| JoyAI adapter | 状态跨请求保存,并异步生成分层摘要 | query 前默认强制 silence,codec 版本尚未公开 |
| StreamArena harness | 按 wall clock 推进,并检查主动输出 deadline | 完整 StreamMind memory agent 尚未开源 |
同一张表里的进度发生在不同方向。StreamingVLM 更接近增量计算,StreamForest 对有界事件压缩说得更清楚,JoyAI 把跨请求状态往前推了一步,StreamArena 则把现实时间评测做得更严格。比较哪套系统更接近 streaming,得先说明看的是哪一条轴。
完整视频已经下载到本地,也不必然导致 future leakage。只要 loader 在时刻 t 只解码从 t 到 t 加 Δ 的区间,内容仍然可以保持 causal。文件访问会带来另一组条件。系统能够随机读取视频,可能知道总时长,也可以高速 replay,因而没有处理网络抖动、camera backpressure 和未知终点。
已知 query timestamp 同样可以服务于严谨裁剪,它本身不会让答案自动变容易。真实系统遇到的麻烦在 query 之间。它无法提前知道下一次问题何时出现,也不能为每道题重新建立一份最合适的状态。评测若把 query 分开运行,状态怎样累积、错误怎样延续、用户如何纠正以及 memory 何时过期,都会离开测量范围。
最终回答很快,也可能因为系统已经在播放期间花了大量计算。VST 正是用 playback time 摊销 reasoning,这个选择在部署中完全合理。实验仍应同时报告每秒更新计算。一个持续占满 GPU 的 background thinker 和一个只在事件出现时更新的系统,可能得到相近的 TTFT,实际资源合同却差得很远。
一套能把系统说清楚的设计空间
单个 streaming 标签装不下今天这些系统。把每套系统放进一个多维空间,差异会看得更清楚。
| 维度 | 可选设计 |
|---|---|
| 可见范围 | 完整离线视频 / 因果前缀 / 近期窗口 / 实时视频流 |
| 输入单位 | 帧 / 片段 / 事件 / 对象 / 压缩表示 |
| 推理方式 | 完整重算 / 窗口重算 / 增量更新 / 循环状态 |
| 状态形式 | 无状态 / 视觉 / KV / 潜变量 / 语义 / 文本 / 混合 |
| 状态预算 | 持续增长 / 固定活跃上下文 / 严格有界 / 自适应 |
| 计算时机 | 提问时 / 播放时 / 周期触发 / 事件触发 |
| 推理层次 | 直接回答 / 局部更新 / 局部思考 / 全局整合 |
| 提问协议 | 固定时刻 / 任意提问 / 持续条件 / 连续运行 |
| 输出类型 | 问答 / 预测 / 通知 / 澄清 / 行动 |
| 交互方式 | 被动 / 响应 / 有条件主动 / 开放式主动 |
| 运行时长 | 短时 / 长时 / 小时级 / 无固定终点 |
| 资源约束 | 不限资源 / token 有界 / 实时约束 / 每秒 FLOPs 有界 |
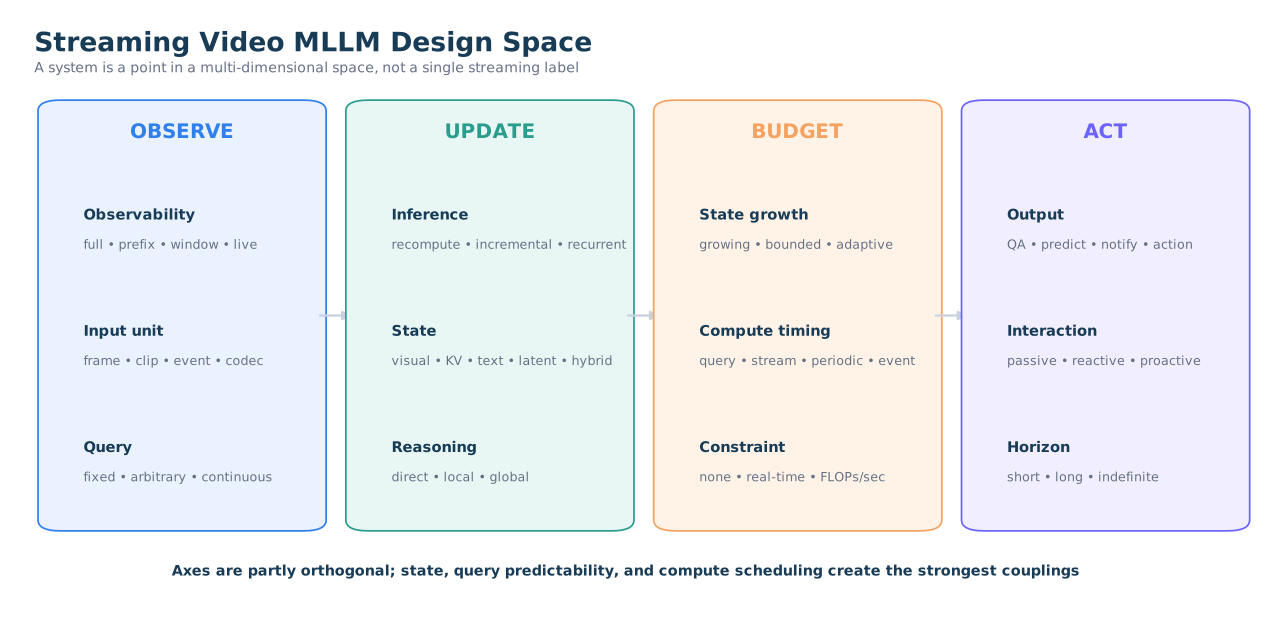
这些轴可以自由组合。因果前缀既能配完整重算,也能配持久 KV。文本状态可以一直增长,也可以用 FIFO 控制长度。主动输出可以只依赖近期窗口,也可以读取层级记忆。Codec 输入同样能够接普通批处理推理或实时 gate。
系统落到实现时,轴与轴之间会互相牵动。状态表示限制了系统怎样遗忘,未来问题的可预测程度决定记忆可以多大程度围绕已知任务写入。播放期间的思考能降低提问延迟,也会增加持续计算,并让错误沿状态传播。窗口一变,信息量、计算量和状态预算都会跟着变化。Codec 选择同时影响可见证据与视觉成本,有时还会改变时间调度。
比较两个系统,至少要把三类预算放在明面上。两边应看到相同的信息,避免把未来访问记成架构收益。总状态与视觉分辨率也要相同,更多 token 不能伪装成更好的记忆。播放期间和提问阶段的计算需要分开记录,才能看清低延迟究竟花了多少持续成本。
从响应问答走向持续视觉智能
多数 benchmark 仍然以问题到答案的映射为中心。
Streaming 改变了回答时能够看到的 prefix。持续运行的系统还要让状态直接参与决策。
每种行动都对应一组具体要求。忽略要权衡误报与计算,写入记忆要交代状态预算和证据来源。预测需要校准置信度与时间范围,通知要考虑截止时间和打断成本,询问负责填补信息缺口,行动还要接上安全约束与回滚接口。
Proactivity 也有不同难度。P0 在 query 后回答。P1 先注册明确的 standing condition,事件发生时不再追加 prompt,StreamArena 的 proactive track 属于这一类。P2 接受较宽的持续指令,再自行选择 speak 或 silence。LiveStarPro narration 和关闭 forced-silence 之后的 JoyAI action policy 更接近这里。P3 允许系统在开放世界中自行决定什么值得关注与通知,目前还缺少严格而系统的验证。
StreamArena 给 P1 提供了更严的 protocol。它包含 243 个视频,平均时长 88.8 分钟,开放式问题涉及 real-time perception、historical recall、tool use 和 proactive interaction。Proactive task 会在 stream 开始或较早时刻给出 standing instruction。目标事件发生时没有新 prompt,输出要落在目标前 0.5 秒到目标后 2 秒之间。公开 harness 按 wall clock 推进,并提供 asynchronous callback interface。论文描述的完整 StreamMind agent 没有随仓库发布,所以 benchmark protocol 与 system blueprint 仍需分开理解。
JoyAI-VL-Interaction 的公开 adapter 已经会维护 per-session raw chunk、mid summaries、long compressed memory、dialogue 和 async jobs。论文配置保留 100 秒 short state、5 个 mid summaries 和 15 个 long blocks,名义上的语义覆盖约 2.08 小时。这里的 2.08 小时指分层文本摘要能够覆盖的时间,不代表视觉细节可以两小时无损保存。默认服务配置会在 query 前强制 silence,论文中的主动 commentary 需要关闭相应 flag。论文提到的 AdaCodec 也没有出现在公开版本中。
MOSS-VL 采用 gated cross-attention,把 visual cache 与 autoregressive language sequence 分开。新帧只编码一次,模型说话时仍能继续接收视觉。公开 driver 支持 camera、screen 和 websocket source。这些实现说明它采用 computationally incremental design。核心 cache 位于尚未完整审计的 remote code,论文机制不能全部视为已经由公开实现复核。论文中的 visual cache 仍然只追加,实验和默认 driver 也依赖有限帧数。边说边看已经能够实现,长期状态是否有界仍需单独回答。
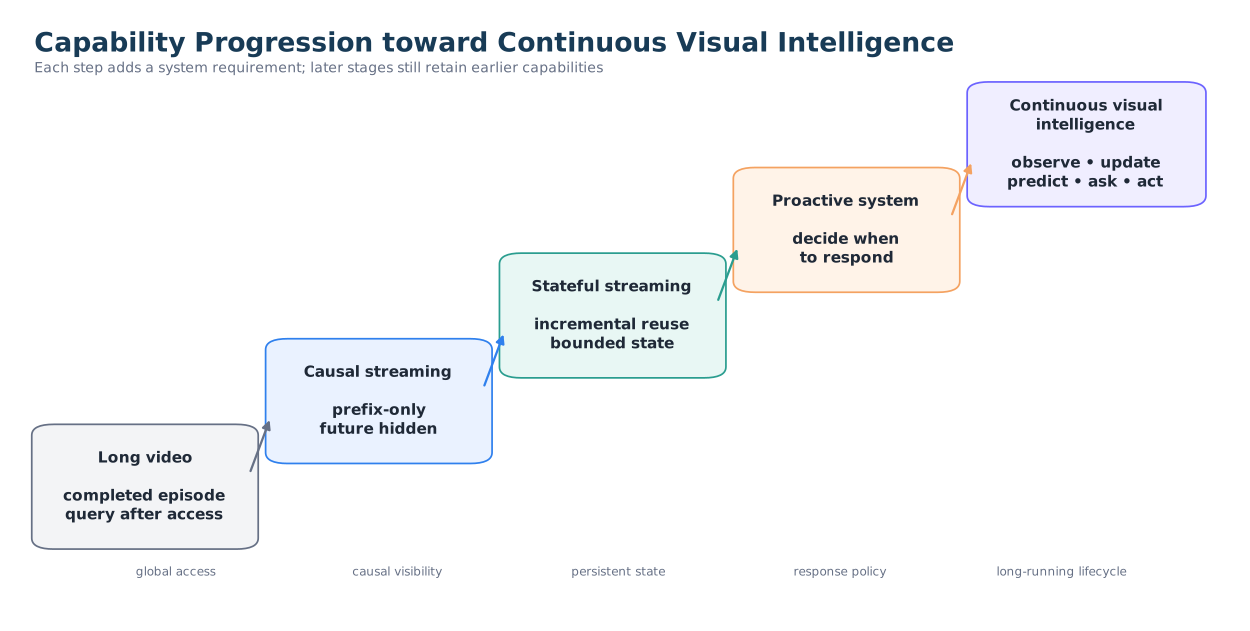
持续视觉智能可以归纳为一组系统条件。输入没有已知终点,未来不可见,状态会在多次提问之间持续存在。主要工作记忆与每秒计算都有预算。系统在播放期间更新状态,问题到来后再完成整合,必要时主动输出;每个答案还应能追溯使用过的状态版本和视觉证据。
八个可以被实验推翻的问题
一,怎样比较不同的 streaming state
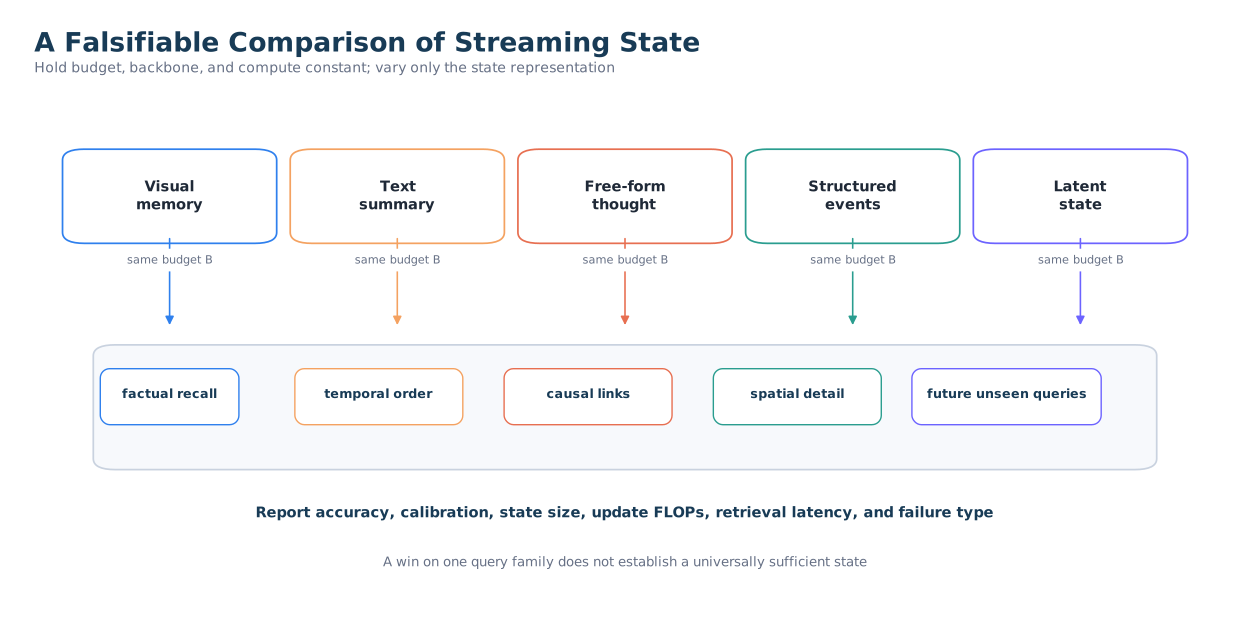
现有论文分别保存 raw frames、visual tokens、KV、caption、free-form thought、event tree、object anchor 或 latent slots,随后在不同 backbone 和预算下比较最终分数。实验一旦这样铺开,state representation、额外 token、训练方式与 stream-time compute 的收益就混在了一起。Text state 容易丢视觉细节,visual state 成本高,latent state 又很难审计。
问题可以收窄到这里。未来 query 未知且总状态预算固定时,哪种表示能保留更广的可用信息,还允许系统纠错并追踪证据来源。可检验的假设是,同预算混合状态会形成一条可解释的 Pareto frontier。近期视觉 token 负责细节,结构化事件状态保存时间关系和因果,少量原始关键帧留作回读。它应在未见问题上超过单一文本状态或视觉状态,也不必在每类任务上都占优。
一组能回答它的最小实验需要固定 backbone、输入、总 token budget B、每秒 update FLOPs 与最终 reasoning budget,然后比较 raw visual、compressed visual、caption、free-form thought、structured event state、latent state 和 hybrid。问题只能在 stream 结束后从未参与写入的 query pool 中抽取。评测分别报告 factual recall、temporal order、causal relation、spatial layout、OCR、identity persistence 和 fine-grained appearance。还可以逐项删掉状态中被判为低价值的内容,观察答案何时改变。这个 deletion probe 会直接暴露压缩器有没有删掉关键证据。
二,Streaming Thinking 得到的是 reasoning 还是 semantic compression
Thought 在不少系统里同时承担观察摘要、实体记录和局部推断。ThinkStream 的 caption 对照没有完全匹配训练目标与 token budget,VST 的 thought target 又是用完整视频 knowledge graph 离线合成的。分数提高以后,我们很难判断自由文本是否只是一种 task-adaptive summary,也无法排除额外 decoding 带来的 test-time compute 收益。
实验可以把视觉信息、token、FLOPs 和训练数据全部固定,只改变状态怎样表达。如果收益来自 reasoning,CoT state 应主要改善多证据组合、counterfactual 与 causal tasks。如果收益来自 compression,extractive summary 或 structured summary 在 factual recall 上应当相近,而且更容易核对事实。
最小对照包括 extractive caption、descriptive summary、fixed-schema event log、free-form rationale、latent update 和 no-op compute control。No-op control 生成等长的 hidden work,却在 final answer 时屏蔽其内容,用来隔离额外计算本身。还可以故意把中间 hypothesis 换成一个似是而非的错误。模型若不能利用后续视觉纠正它,说明 state update 缺少 belief revision,局部错误会在长时间运行中固化。
三,怎样评价 query-agnostic memory
Benchmark 的 query distribution 通常固定,一部分合成数据还会使用最终问题或全视频 evidence trace。Runtime prompt 即使没有 query,训练也可能教会模型优先保存该 benchmark 常问的内容。这样的状态在同分布题型上表现很好,换成新的空间细节、罕见实体或新的任务语言时,可能已经没有证据可用。
研究问题可以写得很具体。未来的 Qfuture 尚未出现时,系统构建的 state 能否越过原有 task family。可证伪的假设是,保存 observation provenance、entity changes 与少量可回读 visual keyframes 的 structured state,会比 free-form summary 更能抵抗 query distribution shift。
最小设置要把写入和提问彻底隔离。训练只出现一组 query families,测试时在同一批 streams 上加入未见题型。任何 test query 暴露前都要冻结 state,同时禁止模型重新观看原视频。更强的版本可以固定 recent window 与 query,只替换较早发生的关键事实。答案若不随这段历史改变,样本或系统可能依赖 prior 与 local clue,没有真正读到长期状态。
四,什么时候值得花计算
固定 fps、固定 chunk、固定 thought interval 与每帧一次 full encoder 都便于训练,却会给静止片段和关键事件分配相近预算。低信息片段浪费 FLOPs,快速事件又可能从 cadence 的缝隙里漏掉。只看 motion 会错过静态 OCR,使用接近主模型规模的 semantic gate 又失去了节省计算的意义。
要验证的是,一个 cheap multi-signal gate 能否在固定 FLOPs per second 下选择视觉编码、state update 与 global thinking 的时刻。具体假设是,codec bitcost 或 residual 加上 scene change、轻量 object novelty 与 model uncertainty 的 hybrid gate,在相同预算下会超过 uniform cadence,也会比 codec-only gate 少漏掉静态高价值事件。
对照组应包含 uniform、scene-cut、codec-only、light semantic、uncertainty、hybrid 和 oracle triggers,并严格匹配平均视觉编码次数与 reasoning tokens。结果要同时记录事件 recall、false trigger、rare static evidence recall 和 answer quality,也要把 energy、backlog 与 deadline miss 算进去。只看最终 QA accuracy 会奖励过度触发的 gate。
五,多时间尺度状态应当怎样更新
真实视觉过程里,毫秒级运动、秒级动作、分钟级事件和小时级目标同时存在,一个 window 很难照顾全部尺度。
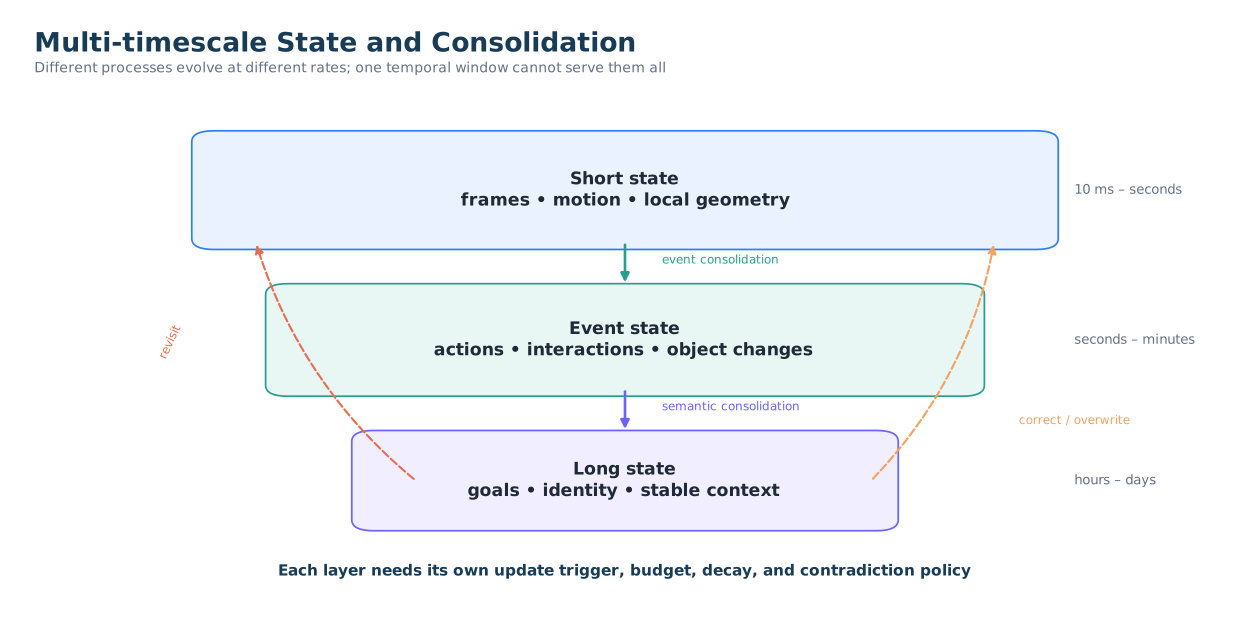
现在不少 hierarchy 只是串起三个长度不同的 buffer,再按固定帧数更新。Event boundary 与固定周期一旦错位,实体可能在跨事件时丢掉身份,semantic summary 也可能在事件结束前过早定型。研究需要回答各层由什么事件触发写入、合并和回读,以及 provenance 怎样穿过层级。
可证伪的假设是,short state 每帧更新,event state 由 boundary、novelty 或 uncertainty 触发,semantic state 只在事件关闭或 belief 改变时更新。这样的异步 hierarchy 应优于相同总预算的 fixed-rate hierarchy。最小验证可以在同一视频中独立操纵 1 到 2 秒动作、1 到 5 分钟事件与 30 到 60 分钟身份或目标依赖,并固定总 state 和 update FLOPs。
收益还应具有尺度选择性。Short layer 改善当前动作,event layer 改善顺序与局部因果,semantic layer 负责身份、目标和长期状态。如果所有提升都来自最大的 buffer,层级结构只是把更多容量藏了起来。
六,怎样知道模型忘对了东西
FIFO、merge、summary overwrite 和低 saliency eviction 通常以回收空间为目标,很少直接检查被删除信息的 future utility。结果可能是 stale fact 与当前状态并存,罕见关键事件被高频内容冲走,相似对象遭到错误合并,早期错误还会在 summary consolidation 以后变得难以修复。
好的遗忘策略要删掉已经无效的状态,保留历史 episode,并在细节确实丢失时承认无法恢复。一个可检验的方向,是给 memory 加上 observation time、valid time、confidence 和 source pointer。Typed memory 若确实有用,应比 free-form summary 更容易纠正矛盾,也更适合 selective forgetting。
可以把 stale-state、contradiction、rare-event、identity-return 与 semantic-to-episodic retrieval 组合成一组最小验证,同时记录每次 eviction 的 estimated utility。分数也不应只看保留率。可以计算 retained useful bits per state byte,或者画 deletion utility curve。按照模型自己的低价值排序逐项删除时,性能若缓慢下降,说明排序有效。最先删掉的内容一旦击中关键证据,memory policy 只完成了压缩,没有学会判断什么值得留下。
七,Streaming benchmark 还缺一份什么样的账本
多数 benchmark 会报告任务 accuracy 和 query latency,对 causal prefix 也规定得比较清楚。跨 query state 怎样延续、stream-time compute 花了多少、外部 memory 增长到哪里,仍缺少统一记录。于是 prefix recomputation 与 persistent state 可能共用一个名称,提前计算看起来像免费加速,active prompt 虽然有界,外部 event database 却可以继续增长。
研究问题是让评测分数同时反映信息因果、状态生命周期、计算可持续性与响应时机。加入统一系统账本和证据距离分层以后,模型排名应发生明显变化。近期窗口、完整前缀与持久状态方法会在不同子指标上显出各自优势,这条预测可以直接被实验推翻。
实验把多次不可预知的问题放在同一条视频时间线上,并禁止模型进程重置。评测器记录帧到达、状态更新、问题出现、回答、淘汰和主动输出的完整轨迹。
最低账目再按五类信息展开。时间项记录现实视频时间、模型计算时间、实时系数、TTFT 与答案完成时间;计算项记录视觉编码和状态更新的每秒 FLOPs;状态项记录 token、字节数和外部存储节点;因果审计记录未来泄漏和丢帧;证据项记录问题不可预测程度,以及最近和最远证据距离。
评测可以分成 causal protocol 与 deployment protocol。前者允许加速重放,但严格限制未来可见性,适合大规模比较能力。后者按 1 倍 wall clock 播放,固定硬件与每秒 compute,用来检查 sustained operation。两套协议回答不同问题,都应保留。
八,怎样评价 proactive intelligence
现有主动任务往往先给持续条件,或者只在标准时刻附近轮询。系统知道监控目标,通知给用户造成的成本却很少进入分数。一个每秒都说话的模型可能拿到很高的事件召回,也会不断打断用户。宽泛模板还能制造大量低价值通知,多个监控目标冲突时则可能挤掉紧急任务。
系统需要在通知预算、误报成本与截止时间下选择忽略、通知、询问和行动。可证伪的假设是,把事件价值、误报、迟到、计算与打断明确写进效用以后,学到的调度会优于彼此独立的二分类检测器,也会在证据不足时学会询问。
最小设置让每段 stream 同时出现价值、误报代价与 deadline 各不相同的事件,每分钟最多通知 k 次,并允许用户撤销或修改 monitor。一个可解释的 utility 可以写成下式。
不同应用会给各项成本不同权重。安防助手会把火情的 miss cost 设得很高,会议助手更在意频繁打断,机器人 action 还要加入安全约束和回滚能力。评价逻辑可以保持一致,参数必须跟着应用改变。
视频还在继续,状态也要继续
把这些论文和代码摊开以后,我的注意力已经从视频切成多少块,转到了状态怎样出生、改写、遗忘,又怎样在出错后被纠正。时间继续拉长,输入、记忆、推理和调度的每个选择都要接受资源上界。
评价一个系统时,我更愿意追问几件具体的事。时刻 t 到来时,它看到了什么,刚刚算了什么,过去还剩下什么。状态会不会一直增长。未来 query 尚未出现,它为何保留眼前这些内容。下一秒输入到来时,它还能不能跟上。
Streaming Video Intelligence 在一个持续展开且终点未知的世界中运行。系统只使用已经到达的观察,以有界 working state 和有界每秒计算持续更新理解,并为尚未出现的问题、预测、通知与行动保留足够且可追溯的证据。
这条路还很长。下一次再看到 Streaming 写进标题,我会先看那份状态能活多久,再看视频被切成了多少块。
实现与评测索引
下面汇总正文依赖的实现边界,方便集中查阅。论文方法、公开评测与本文解释若有差异,正文已经分别说明。
Benchmark 与增量推理
| 项目 | 公开实现能够支持的结论 |
|---|---|
| OVO-Bench | OVOBench.py、chunk_videos.py 与 VideoLLM_Online.py 使用预裁 causal prefix。每条 query 或 probe 独立运行,online adapter 会跨 call reset。 |
| lmms-eval OVO | ovobench/utils.py 与 qwen2_vl.py 的 Forward multi-round 每轮重新处理完整 prefix,普通 adapter 不跨 probe 复用视觉 KV。 |
| StreamingBench | StreamingBench.py、StreamingBenchSQA.py 与 StreamingBenchProactive.py 分别处理 timestamp crop、只传 oracle text history 的 SQA,以及每秒 polling 重算的 proactive output。 |
| VST | qwen2_5_vl_stream_think.py 与 qwen2_5_vl_sf.py 显示 OVO 路径使用 current chunk 加外部文本递归,跨 query 重建。当前 StreamingBench 路径采用 single-pass。 |
| StreamingVLM | inference.py 中的 process_past_kv、prune_id_and_kv_cache 与 streaming_inference 让新视觉只编码一次,KV 跨秒持续,并物理淘汰旧视觉和 previous-text 中段。 |
| StreamingLLM | kv_cache.py、modify_llama.py 与 run_streaming_llama.py 用 attention sink 加 recent K/V 支持持续文本解码,没有提供 long-term recall。 |
| ThinkStream | StreamingInferenceEngine.generate、maybe_evict 与 CacheEviction.evict 采用增量更新的 static KV。Visual span 会被淘汰,reasoning 与 action KV 没有长期 consolidation。 |
| StreamingThinker | generate.py 的公开主循环交替推进 source 与 reasoning,没有看到独立并发 scheduler。 |
| TaYS | model.py 与 livecc_infer.py 的一个主要路径会先编码完整视觉,再多次调用 generate。论文中的双 cache 真并发仍无法从公开版本完整审计。 |
| SimpleStream | query_recent_window 与 eval_streamingbench.py 在每个 query 取最近 N 帧并重新推理,没有 feature cache。 |
| ViCoStream | run_incremental_generate 与 modeling_qwen2_5_vl_INC.py 实现增量 KV 和 bounded attended history。公开版本没有展示 stage concurrency 与 KV eviction。 |
State 与持续系统
| 项目 | 公开实现能够支持的结论 |
|---|---|
| StreamForest | MemoryManager 与 ToMe_FSTW_PEMF.forward 实现有界方法状态。官方评测在每次 forward 新建 manager,并从 prefix 重建。 |
| ObjectStream | EntityMemoryBank 与 EntityMem.process_memory_streaming 可以持续更新 standalone bank。Benchmark 主路径仍在每个 sample 内局部重建。 |
| LiveStarPro | tshm.py 与 streaming_infer.py 的公开 tree 只保存 caption。Streaming loop 前会预编码完整视频,检索包含全树扫描。 |
| JoyAI-VL-Interaction | live_adapter.py 与 memory_summarizer.py 已实现跨请求 session state 和异步摘要。Query 前默认 forced silence,AdaCodec 尚未发布。 |
| MOSS-VL | run_online_inference.py 与 video_sources.py 支持 live sources,同一 session 可以增量 push frame。核心 cache 位于尚未完整审计的 remote code。 |
| StreamArena | streammind/agent.py 与 run_streammind.py 提供 wall-clock harness 和 agent interface,完整 StreamMind agent 尚未开源。 |
Codec 路径
| 项目 | 公开实现能够支持的结论 |
|---|---|
| codec-video-prep | run_preinfer 会进入 bitcost 与 readiness 路径,再完成 canvas packing,输出 RGB canvas 和 source coordinates。 |
| OneVision-Encoder | OneVisionEncoderModel.forward 与 VideoRotaryEmbeddingSplit466 显示 codec signal 选择 decoded RGB patches,并保留 3D source coordinates。 |
| LLaVA-OneVision-2 | process_codec_video 与 processing_llava_onevision2.py 表明 runtime 由主 processor、remote code 和 preprocessing package 共同组成。 |
| Mage-VL | inference_streaming.py 与 streammind_gate.py 的公开 demo 会预处理完整视频,传统 codec route 委托给 bitcost 与 readiness。 |
参考文献
- Junming Lin et al. StreamingBench. Official code.
- Yifei Li, Junbo Niu et al. OVO-Bench. Official code.
- Yujiao Shen et al. A Simple Baseline for Streaming Video Understanding. Official code.
- Guangxuan Xiao et al. Efficient Streaming Language Models with Attention Sinks. Official code.
- Ruyi Xu et al. StreamingVLM. Official code.
- Yang Tan et al. ViCoStream. Official code.
- Junlong Tong et al. StreamingThinker. Official code.
- Jialiang Zhang et al. Think-as-You-See. Official code.
- Yiran Guan et al. Video Streaming Thinking. Official code.
- Zikang Liu et al. Thinking in Streaming Video. Official code.
- Yiran Guan et al. ThinkOmni. Official code.
- Zifan Han et al. WAT.
- Xiangyu Zeng et al. StreamForest. Official code.
- Zhenyu Yang et al. LiveStarPro. Official code.
- Mingkang Dong et al. ObjectStream. Official code.
- Muxin Fu et al. StreamFlow. Official project page.
- Feilong Tang et al. OneVision-Encoder, Codec-Aligned Sparsity as a Foundational Principle for Multimodal Intelligence. Official code.
- codec-video-prep maintainers. codec-video-prep v0.2.5. Software repository.
- Xiang An et al. LLaVA-OneVision-2. Official code.
- Senqiao Yang et al. Mage-VL. Official code.
- Dingyu Yao et al. JoyAI-VL-Interaction. Official code.
- Xichen Zhang et al. StreamArena. Official benchmark and harness code.
- Pengyu Wang et al. MOSS-VL Technical Report. Official code.
- Keming Wu et al. StreamOPD. Official code.
- EvolvingLMMs-Lab. lmms-eval. Evaluation framework.